Haobai Wang · 公开阅读版 · ch05-zh-96ce49ea02f7
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 96ce49ea02f739700393d1febed32c353be47bcedc2f0cb0fb4f149020917782
《偶然的数学》
第二卷 · 无限世界中的概率
第五章:无限世界的代价——为什么概率需要测度论?
当人类试图测量一切集合时,最终发现:不是每一个集合都能够拥有我们所希望的大小。
在前四章中,我们走过了一条漫长的道路。
最开始,我们只有一场尚未结束的赌博。
为了公平地分配奖金,我们开始计算尚未发生的未来,逐渐发现了概率、独立性和期望的思想。
随后,我们尝试通过观察认识未知的概率,并发现重复实验能够产生稳定的统计规律。
接着,正态分布从二项式与独立随机和的极限中出现。
最后,我们沿着离散随机游走,辨认出了连续 Brownian motion 应当具有的结构,也遇到了尚需解决的路径问题。
现在,随机性已经不仅存在于有限的赌博结果中,还存在于实数、连续函数,甚至无限维的空间之中。
但我们一直没有认真回答一个问题。
当我们写下
P(A)时,这个符号究竟意味着什么?
对于一枚公平骰子,我们可以说:
P(A)=\frac{|A|}{6}.因为我们只有六种等可能结果。
可是对于 Brownian motion,我们能够提出这样的事件:
A=
\left\{
\omega:
\sup_{0\le t\le1}B_t(\omega)>1
\right\}.
这里的 \omega 不再只是一个数字。
它代表了整个随机运动的一种可能实现。
而 A 包含的是所有曾经越过高度1的随机路径。
这样的集合既不是有限的,也无法通过简单计数衡量。
我们却依然希望计算它的概率。
于是,一个似乎十分自然的想法出现了:
既然概率是集合大小的一种度量,我们为什么不先建立一种能够测量任意集合大小的数学理论,再把它应用到随机现象上?
这看起来只是一个技术问题。
但接下来,我们会发现,它实际上隐藏着一个数学上的不可能性。
5.1 一次看似最简单的随机实验
假设我们在区间 [0,1] 中随机选择一个实数。
为了避免预先使用尚未定义的概率语言,我们暂且把这种实验称为“均匀选择”。
这意味着,我们希望数字落入某个区间的机会,与区间的长度成正比。
例如:
P\left(X\in\left[0,\frac12\right]\right)=\frac12,P\left(X\in\left[\frac14,\frac34\right]\right)=\frac12.更一般地,对于
0\le a<b\le1,我们希望
\boxed{P(X\in[a,b])=b-a.}端点是否包含并不影响我们想要的结果。
这个要求似乎非常合理。
因为“均匀”意味着,区间的位置不应影响它被选中的机会;只有它所占据的长度才重要。
可是,一个区间只是实数集合中的一种特殊情况。
我们还可能问:
数字落在有理数集合中的概率是多少?
落在 Cantor 集中的概率是多少?
落在一个十分复杂、既不是区间也不是有限并的集合中的概率又是多少?
如果我们希望概率论能够处理所有这些问题,那么就必须把定义从区间推广到更一般的集合。
于是,我们尝试寻找一个函数
m:\mathcal P(\mathbb R)\longrightarrow[0,\infty],其中 \mathcal P(\mathbb R) 表示所有实数子集构成的幂集。
我们希望它满足以下性质:
首先,区间应该具有通常的长度:
m([a,b])=b-a.其次,平移不能改变集合的大小:
m(A+x)=m(A),其中
A+x=\{a+x:a\in A\}.最后,如果一组集合互不重叠,那么它们合起来的大小应该等于各部分大小之和。
我们甚至希望对于无限多个互不相交的集合也成立:
\boxed{
m\left(\bigcup_{n=1}^{\infty}A_n\right)
=
\sum_{n=1}^{\infty}m(A_n).
}
这就是可数可加性。
这三个要求似乎都十分自然。
但它们真的能够同时成立吗?
在回答之前,我们先看看无限集合究竟怎样改变了人类对于“大小”的理解。
5.2 为什么元素的数量不再能够代表集合的大小?
在有限集合中,最自然的大小概念就是元素个数。
例如,设
A=\{1,2,3\},\qquad B=\{1,2,3,4,5\}.我们显然认为 B 比 A 大。
因为
|A|=3,\qquad |B|=5.但在无限集合中,事情开始变得奇怪。
例如,自然数集合
\mathbb N=\{1,2,3,\ldots\}与偶数集合
2\mathbb N=\{2,4,6,\ldots\}之间存在双射:
n\longmapsto2n.所以它们具有相同的基数。
即使偶数只是自然数的一部分,在 Cantor 的基数理论中,它们仍然一样大。
这件事对于无限集合并不矛盾。
只是说明有限集合的计数直觉已经不能完整描述无限集合。
现在考虑我们真正关心的连续区间。
映射
f:[0,1]\longrightarrow[0,1/2],
\qquad
f(x)=\frac x2
是一个双射。
因此
\left|[0,1]\right|
=
\left|[0,1/2]\right|.
但若按照通常的长度衡量,
m([0,1])=1,而
m([0,1/2])=\frac12.这里并没有矛盾。
因为基数与长度本来就是两种不同的数学概念。
真正的问题是:
能否为无限集合创造一种新的大小概念,使它既能够继承区间长度,又能保留有限计数中合理的加法性质?
5.2.1 一个稠密的集合,竟然可以有零长度
考虑
A=\mathbb Q\cap[0,1].有理数在 [0,1] 中稠密。
这意味着,无论我们选择多么小的非空开区间,只要它落在 [0,1] 内,就能找到有理数。
如果只依靠几何直觉,这个集合似乎“遍布”整个区间。
然而,如果我们希望每个单独的点都具有零长度:
m(\{x\})=0,并且 m 满足可数可加性,那么由于有理数可数,我们可以把它们列出来:
A=\{q_1,q_2,\ldots\}.于是
\begin{aligned}
m(A)
&=m\left(\bigcup_{n=1}^{\infty}\{q_n\}\right)\\
&=\sum_{n=1}^{\infty}m(\{q_n\})\\
&=0.
\end{aligned}
因此
\boxed{m(\mathbb Q\cap[0,1])=0.}反过来,
m\bigl([0,1]\setminus\mathbb Q\bigr)=1.这意味着,在我们希望建立的均匀概率模型中:
\boxed{P(X\text{ 是有理数})=0.}而
\boxed{P(X\text{ 是无理数})=1.}这已经非常不同于有限空间的概率直觉。
在有限的等可能空间中,一个非空事件总拥有正概率。
但在连续空间中,一个事件可以包含无穷多个结果,却仍然具有零概率。
甚至,一个事件可以在拓扑意义下稠密,却在测度意义下为零。
这里,我们第一次看到三种不同的“大小”:
- 基数:一个集合包含多少元素?
- 拓扑性质:这个集合在空间中如何分布?
- 测度:这个集合占据了多少可测量的大小?
它们不是同一回事。
而概率论真正需要的,将是第三种。
不过,到目前为止,我们的困难似乎只是技术上的。
虽然无限集合很奇怪,但我们依然能够给有理数、无理数、区间等集合赋予合理的大小。
真正的危机,还没有出现。
5.3 一场失败的尝试:我们真的能够测量所有集合吗?
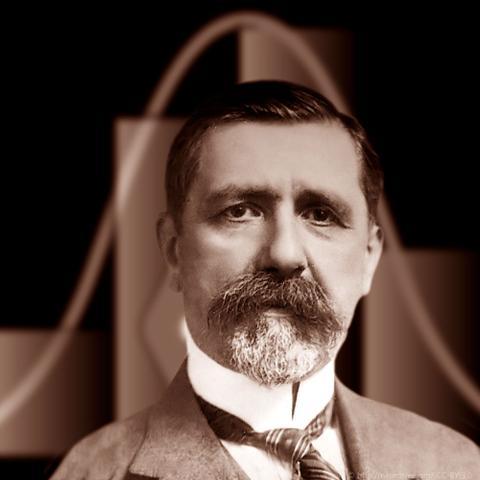
Émile Borel(1871—1956)
法国数学家。1898年,他研究了从区间及其可数集合运算出发能够得到的集合与测度结构。
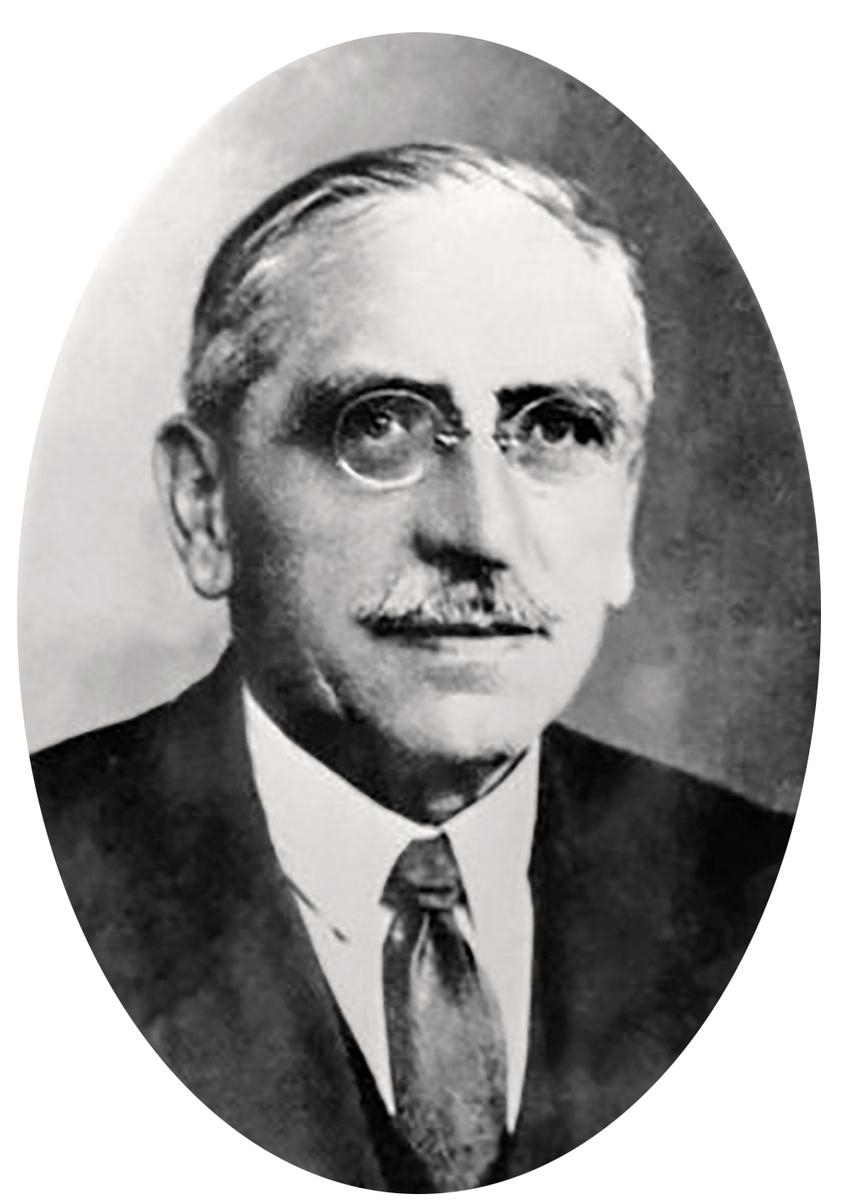
Henri Lebesgue(1875—1941)
法国数学家。他在1902年的博士论文中发展了关于长度、面积和积分的新理论,使得远比区间复杂的集合与函数能够被系统研究。
十九世纪末至二十世纪初,Cantor 的集合论、Borel 的集合研究,以及 Lebesgue 的测度与积分理论,使数学家能够处理越来越复杂的无限集合。
然而,一个非常自然的问题仍然存在:
如果我们已经可以测量这么多集合,为什么不能干脆测量全部集合?
1905年,意大利数学家 Giuseppe Vitali 给出了一个令人震惊的答案。
在通常的选择公理下,不可能给实数的所有子集赋予一种同时具有平移不变性、可数可加性且与区间长度一致的测度。
这不是因为数学家暂时没有找到合适的构造方法。
我们来亲自证明。
5.3.1 首先,把实数分成许多等价类
在区间 [0,1] 上定义关系
x\sim y
\quad\Longleftrightarrow\quad
x-y\in\mathbb Q.
也就是说,如果两个实数之间的差是有理数,我们就认为它们等价。
这个关系确实满足等价关系的三个条件。
自反性:
x-x=0\in\mathbb Q.对称性:
x-y\in\mathbb Q
\implies y-x\in\mathbb Q.
传递性:
x-y\in\mathbb Q,\quad y-z\in\mathbb Q
\implies x-z\in\mathbb Q.
因此,这个关系将 [0,1] 划分成一系列互不相交的等价类。
每个等价类都是一个可数集合,因为它包含在某个形如
x+\mathbb Q的集合中。
但是,整个 [0,1] 不可数。
所以这些等价类有不可数多个。
到这里,似乎一切正常。
接下来,我们做一件看起来没有任何危险的事情:
从每个等价类中,恰好选出一个代表元素。
将这些代表元素组成的集合记作 V。
于是
V\subseteq[0,1],并且 V 与每一个等价类恰好相交一次。
这就是 Vitali 集。
这里需要用到选择公理:我们同时对不可数多个等价类各选择一个代表元素。
我们并没有给出这些代表元素的显式公式,而是借助集合论的选择原则断言这样的集合存在。
5.3.2 把这个集合平移无数次
现在考虑有理数集合
Q_0=\mathbb Q\cap[-1,1].对于每一个 q\in Q_0,定义平移集合
V_q=V+q.我们首先证明:
对于不同的 q,r\in Q_0,
V_q\cap V_r=\varnothing.假设不是这样。
那么存在 v,w\in V,满足
v+q=w+r.因此
v-w=r-q\in\mathbb Q.所以
v\sim w.但 V 中每个等价类只有一个代表元素,因此
v=w.代回原式得到
q=r,与假设矛盾。
所以这些平移集合确实两两不相交。
第二步,我们证明:
\boxed{
[0,1]\subseteq
\bigcup_{q\in Q_0}(V+q).
}
任取 x\in[0,1]。
由于 V 包含 x 所在等价类的代表元素,存在 v\in V 满足
x-v\in\mathbb Q.又因为 x,v\in[0,1],
-1\le x-v\le1.所以令
q=x-v\in Q_0,便有
x=v+q\in V+q.因此区间 [0,1] 确实被这些平移集合覆盖。
另一方面,所有这些集合都位于
[-1,2]之内。
于是得到:
\boxed{
[0,1]
\subseteq
\bigcup_{q\in Q_0}(V+q)
\subseteq[-1,2].
}
到目前为止,我们还没有使用任何关于测度的假设。
整个构造完全来自集合论。
5.3.3 现在,让测度来决定这个集合的大小
假设我们真的能够建立一个定义在所有实数子集上的测度 m,并满足本章开头提出的三个要求。
特别是平移不变性:
m(V+q)=m(V).令
c=m(V).因为 V\subseteq[0,1],由单调性可知
0\le c\le1.由于 Q_0 是可数无限集,而各个 V+q 两两不相交,可数可加性给出
\begin{aligned}
m\left(\bigcup_{q\in Q_0}(V+q)\right)
&=\sum_{q\in Q_0}m(V+q)\\
&=\sum_{q\in Q_0}c.
\end{aligned}
现在只有两种可能。
情况一:c=0。
那么
m\left(\bigcup_{q\in Q_0}(V+q)\right)=0.但是这个并集包含 [0,1],所以它的测度至少是1。
于是
1\le0.矛盾。
情况二:c>0。
因为我们把同一个正数相加可数无限次,
\sum_{q\in Q_0}c=\infty.因此
m\left(\bigcup_{q\in Q_0}(V+q)\right)=\infty.但是这个并集又包含在 [-1,2] 内。
按照区间长度,
m([-1,2])=3.所以它的测度最多只能是3。
于是
\infty\le3.仍然矛盾。
无论 m(V)=0,还是 m(V)>0,我们都会得到矛盾。
所以我们最终证明:
\boxed{
\begin{gathered}
\text{不存在定义在 }\mathcal P(\mathbb R)\text{ 上的}\\
\text{平移不变、可数可加、}\\
\text{并与区间长度一致的测度。}
\end{gathered}
}5.3.4 我们究竟失败在什么地方?
这个证明最值得回味的地方,是我们并没有使用任何特别复杂的计算。
我们只进行了三个操作:
选择代表元素。
平移集合。
把互不相交集合的大小相加。
每一个步骤看起来都很自然。
但它们组合在一起,却产生了无法解决的矛盾。
这意味着,我们最初的一些愿望不能全部实现。
如果我们坚持区间长度、平移不变性和可数可加性,那么就必须放弃一个要求:
不是每一个实数子集都必须被赋予测度。
当然,这个结论需要精确理解。
它并不意味着任何概率空间都不可能给所有子集赋予概率。例如,单点集中全部概率的 Dirac 测度完全可以定义在 \mathcal P(\mathbb R) 上。
真正不可能的是,在所有子集上建立我们所要求的那种与均匀长度相容的测度。
这一区别很重要,因为它告诉我们:
可测性不是集合本身脱离测度体系而具有的一种绝对属性。它与我们选择的测度结构密切相关。
现在我们面对一个新的问题。
既然不能测量所有集合,那么究竟应该测量哪些集合?
这就引导我们走向 \sigma-代数。
5.4 为什么数学家需要发明 \sigma-代数?
假设我们决定放弃测量所有子集的要求。
我们只选择其中一部分集合,为它们赋予概率。
将这些允许测量的集合组成一个集合族,记作
\mathcal F\subseteq\mathcal P(\Omega).现在,\mathcal F 应该具有什么性质?
我们先不要急着给出定义。
让我们重新想一想概率事件之间最基本的逻辑关系。
如果事件 A 可以被赋予概率,那么“不发生 A”也应该是一个可以讨论的事件。
因此
A\in\mathcal F
\implies A^c\in\mathcal F.
如果两个事件 A,B 都可以被测量,那么“A 或者 B 发生”也应该可以被测量。
因此我们希望
A,B\in\mathcal F
\implies A\cup B\in\mathcal F.
但在无限随机实验中,仅仅对两个事件求并是不够的。
例如:
某个随机游走是否会在未来某个时刻回到原点?
设
A_n=\{S_n=0\}.那么“至少有一次回到原点”就是
\bigcup_{n=1}^{\infty}A_n.“无穷多次回到原点”则是
\bigcap_{m=1}^{\infty}
\bigcup_{n=m}^{\infty}A_n.
这些事件都涉及无限次集合运算。
如果我们的可测事件体系不能处理它们,就很难研究随机过程的长期行为。
因此,我们自然希望:
只要每一个 A_n 都是可以测量的事件,那么
\bigcup_{n=1}^{\infty}A_n也应该可以被测量。
这就产生了 \sigma-代数的定义。
定义 5.1:\sigma-代数
设 \Omega 是非空集合。
如果集合族
\mathcal F\subseteq\mathcal P(\Omega)满足:
\Omega\in\mathcal F;- 若
A\in\mathcal F,则A^c\in\mathcal F; - 若
A_1,A_2,\ldots\in\mathcal F,则
\bigcup_{n=1}^{\infty}A_n\in\mathcal F,那么称 \mathcal F 是 \Omega 上的一个 \sigma-代数。
其中的元素称为可测集合。
这就是定义。
但现在我们应该能理解,为什么它是这样的。
它不是一组三条毫无关联的形式要求。
它们分别对应:
整个实验必然发生。
事件的否定。
可数个事件之间的逻辑组合。
而且,利用 De Morgan 定律,
\left(\bigcup_{n=1}^{\infty}A_n\right)^c
=
\bigcap_{n=1}^{\infty}A_n^c,
我们立即得到
A_n\in\mathcal F\ (\forall n)
\implies
\bigcap_{n=1}^{\infty}A_n\in\mathcal F.
所以一个 \sigma-代数可以同时处理可数并和可数交。
5.4.1 为什么是可数,而不是任意多个?
这是一个值得单独思考的问题。
既然有限并不够,为什么我们不干脆要求对任意并都封闭?
假设 \mathcal F 包含实数轴上的所有单点集合:
\{x\}\in\mathcal F,
\qquad x\in\mathbb R.
如果 \mathcal F 对任意并都封闭,那么任意集合 A\subseteq\mathbb R 都满足
A=\bigcup_{x\in A}\{x\}\in\mathcal F.于是
\mathcal F=\mathcal P(\mathbb R).我们又回到了 Vitali 证明中已经失败的起点。
因此,可数并与任意并之间的区别,并不是数学家随意设立的技术限制。
它允许我们保留强大的极限运算能力,同时又不必把全部子集都放进可测体系。
这在概率论中尤其重要。
因为自然数所索引的随机序列、极限和、极限交,以及大量随机过程的路径事件,都可以通过可数次操作来表达。
但是一般的不可数并不一定可测。
这将影响我们以后处理连续时间随机过程时使用的方法。
5.5 可测事件不是越多越好吗?
现在设想有两个 \sigma-代数
\mathcal F_1\subseteq\mathcal F_2.如果我们把它们看作可以区分的事件集合,那么 \mathcal F_2 允许我们区分更多情况。
这提示了一种现代概率论中非常重要的解释:
\sigma-代数可以被看作某种信息结构。
例如,一枚硬币尚未抛掷时,我们只考虑必然事件和不可能事件:
\mathcal F_0=\{\varnothing,\Omega\}.抛掷之后,若结果空间为
\Omega=\{H,T\},我们便能够区分正面和反面:
\mathcal F_1=\mathcal P(\Omega).于是
\mathcal F_0\subseteq\mathcal F_1.后者包含了更多可辨别事件。
当然,“可测事件”与“观察者实际知道什么”并非在所有场景下都可以直接等同。这里是一种数学解释,之后我们还需要通过条件期望和滤过(filtration)使其变得精确。
但这已经预示了未来的一个重要思想:
当我们研究随机过程时,不仅要问什么事情发生了,还要问在某个时间,我们已经获得了多少关于随机世界的信息。
于是会出现递增的 \sigma-代数族:
\mathcal F_s\subseteq\mathcal F_t,
\qquad s\le t.
这将成为鞅理论的基础。
所以我们现在引入的抽象集合族,未来不仅用来保证概率可以严格定义,也将直接描述信息如何随时间增长。
这一点在条件期望章节中会变得特别重要。
5.6 Borel 集:怎样从最简单的集合,建立一个足够丰富的可测世界?
现在我们终于可以回答:
既然不能测量所有实数子集,那么我们至少应该测量哪些集合?
最自然的出发点仍然是区间。
因为区间具有明确的几何长度。
所以,我们首先要求所有开区间都可测。
然后,根据上一节的讨论,只要某些集合可以测量,它们的补集、可数并和可数交也应该可以测量。
于是,一个构造问题出现了:
从所有开区间出发,不断进行这些允许的集合运算,我们最终能够得到什么?
为了严格表达这件事,先引入生成的概念。
给定一个集合族 \mathcal C\subseteq\mathcal P(\Omega),定义
\boxed{
\sigma(\mathcal C)
=
\bigcap\left\{
\mathcal F:
\mathcal F\text{ 是 }\sigma\text{-代数},
\ \mathcal C\subseteq\mathcal F
\right\}.
}
因为任意多个 \sigma-代数的交仍然是 \sigma-代数,所以这个定义确实产生了一个包含 \mathcal C 的最小 \sigma-代数。
我们称之为由 \mathcal C 生成的 \sigma-代数。
现在设 \mathcal O 为 \mathbb R 上所有开集构成的集合族。
定义
\boxed{
\mathcal B(\mathbb R)=\sigma(\mathcal O).
}
这就是实数轴上的 Borel \sigma-代数。
它包含开集、闭集,以及通过可数次并、交、取补所能产生的全部集合。
一个非常有用的事实是:
\boxed{
\mathcal B(\mathbb R)
=
\sigma\bigl(\{(a,b):a,b\in\mathbb Q,\ a<b\}\bigr).
}
为什么只需要有理端点的区间?
因为任何开集 U\subseteq\mathbb R 都能写成
U=
\bigcup_{\substack{a,b\in\mathbb Q\\(a,b)\subseteq U}}
(a,b).
而有理端点的区间只有可数多个。
所以即使一个开集具有十分复杂的结构,我们仍然能利用可数个简单区间重建它。
这与我们之前反复遇到的可数性思想形成了联系。
连续空间虽然包含不可数多个点,但很多重要的拓扑和测度结构,仍然可以由可数的基本对象生成。
这种性质将来会在可分度量空间、随机过程的可测性,以及概率测度的弱收敛中反复发挥作用。
不过,我们现在只解决了“哪些集合允许测量”的问题。
还没有解决:
这些集合的测度究竟应该是多少?
我们需要真正构造一个函数
m:\mathcal B(\mathbb R)\to[0,\infty].而且它必须满足我们原先希望的区间长度与可数可加性要求。
这就是下一步。
5.7 Lebesgue 的思想:能不能从外面包住一个集合,测量它的大小?
想象一个集合 A\subseteq\mathbb R。
它可能非常复杂,根本不能直接写成几个区间。
但我们可以尝试用一系列开区间覆盖它。
假设
A\subseteq\bigcup_{n=1}^{\infty}I_n,其中每个 I_n 都是开区间。
既然整个覆盖所用区间的总长度是
\sum_{n=1}^{\infty}|I_n|,那么 A 本身的长度应该不超过这个数。
但是不同的覆盖可能给出完全不同的总长度。
我们自然希望找到最经济的覆盖方式。
因此定义
\boxed{
m^*(A)
=
\inf\left\{
\sum_{n=1}^{\infty}|I_n|:
A\subseteq\bigcup_{n=1}^{\infty}I_n,
\ I_n\text{ 为开区间}
\right\}.
}
这里的 m^* 称为 Lebesgue 外测度(outer measure)。
这是一种非常漂亮的构造。
我们不再试图直接测量任意复杂集合。
而是用已经知道怎样测量的区间,从外面逼近它。
对于区间,这种构造会给出通常的长度。
例如,
m^*([a,b])=b-a.其中上界可以通过用长度任意接近 b-a 的开区间覆盖获得。
下界则来自区间的紧致性:任意开区间覆盖 [a,b] 都具有有限子覆盖,而覆盖整个区间的有限区间总长度不能小于 b-a。
这一步使通常的几何长度成为了更一般集合大小概念的一部分。
5.7.1 外测度具有哪些性质?
首先,
m^*(\varnothing)=0.其次,如果
A\subseteq B,那么任何覆盖 B 的开区间族都同时覆盖 A。
因此
\boxed{m^*(A)\le m^*(B).}也就是说,外测度具有单调性。
现在考虑一列任意集合
A_1,A_2,\ldots.对于任意 \varepsilon>0,我们可以为每个 A_k 选择一组开区间覆盖,使得其总长度不超过
m^*(A_k)+\frac{\varepsilon}{2^k},这里先假设相应外测度有限;如果某项为无穷大,所需不等式立即成立。
把这些覆盖全部合在一起,就得到 \bigcup_kA_k 的一组开区间覆盖。
因此
m^*\left(\bigcup_{k=1}^{\infty}A_k\right)
\le
\sum_{k=1}^{\infty}m^*(A_k)+\varepsilon.
令 \varepsilon\downarrow0,得到
\boxed{
m^*\left(\bigcup_{k=1}^{\infty}A_k\right)
\le
\sum_{k=1}^{\infty}m^*(A_k).
}这称为可数次可加性上界,即可数次次可加性(countable subadditivity)。
注意,这里我们得到的是不等式,而不是等式。
这意味着外测度已经能够赋予每一个实数子集某种非负的广义大小。
但它并不能保证在所有互不相交集合上满足可数可加性。
这并不奇怪。
因为 Vitali 的定理已经告诉我们,如果外测度同时保持平移不变性和区间长度,那么它不可能在所有子集上满足可数可加性。
于是问题发生了转变。
我们已经拥有一个定义在所有子集上的外测度。
现在需要寻找那些使外测度表现得像真正测度的集合。
这就是可测性的另一个自然来源。
5.8 Carathéodory:什么样的集合才应该被允许测量?
校订补注:本节的有限并闭合性、可数并及可数可加性的展开证明见附录 A;开覆盖切点处理见附录 B。
考虑任意集合 A\subseteq\mathbb R。
假设我们把另一个集合 E 分成两部分:
E\cap A与
E\setminus A.它们显然互不相交,并且
E=(E\cap A)\cup(E\setminus A).由外测度的次可加性,我们总有
m^*(E)
\le
m^*(E\cap A)+m^*(E\setminus A).
但如果 A 真的是一个能够与长度概念相容的集合,我们似乎还应该期待:
将任意集合 E 按照是否属于 A 划分,不会凭空改变总的外测度。
换句话说,我们希望
m^*(E)
=
m^*(E\cap A)+m^*(E\setminus A).
注意这里一个非常重要的细节。
我们并不是只要求这个等式在 E=\mathbb R 或 E=A 时成立,而是要求它对任意集合 E 成立。
这正是 Carathéodory 可测性准则的思想。
定义 5.2:Carathéodory 可测集
给定外测度 m^*,如果集合 A\subseteq\mathbb R 满足:
对于任意 E\subseteq\mathbb R,
\boxed{
m^*(E)
=
m^*(E\cap A)+m^*(E\setminus A),
}
那么称 A 是 Lebesgue 可测的。
记所有这样的集合构成的集合族为
\mathcal L.这个定义初看比 \sigma-代数的定义更抽象。
但我们已经知道它的来源。
外测度虽然可以测量任意集合,却可能不满足可加性。
因此,我们希望找到一种集合:用它切割任何其他集合时,都不会破坏我们希望保留的加法性质。
Carathéodory 在二十世纪初将这样的思想发展成一般外测度理论的重要构造工具。〔52, 53〕
现在来看它真正有力量的地方。
5.8.1 为什么这套可测集合自动形成一个 \sigma-代数?
我们先研究闭包性质。
由于定义对 A 与 A^c 完全对称,
A\in\mathcal L
\implies A^c\in\mathcal L.
而通过对集合反复使用可测性等式,可以证明,如果 A,B\in\mathcal L,则
A\cup B\in\mathcal L.更一般地,设 A_1,A_2,\ldots\in\mathcal L。
将它们转化为两两不相交的集合:
B_1=A_1,B_n=A_n\setminus\bigcup_{k=1}^{n-1}A_k,\qquad n\ge2.这些 B_n 都是可测集合。
而且
\bigcup_{n=1}^{\infty}A_n
=
\bigsqcup_{n=1}^{\infty}B_n.
对于任意 E\subseteq\mathbb R,反复使用有限次的可测性分割,可以得到
m^*(E)
\ge
\sum_{k=1}^{N}m^*(E\cap B_k)
+
m^*\left(E\setminus\bigcup_{k=1}^{\infty}B_k\right).
令 N\to\infty,并利用外测度的次可加性,
m^*\left(E\cap\bigcup_{k=1}^{\infty}B_k\right)
\le
\sum_{k=1}^{\infty}m^*(E\cap B_k),
得到
m^*(E)
\ge
m^*\left(E\cap\bigcup_{k=1}^{\infty}B_k\right)
+
m^*\left(E\setminus\bigcup_{k=1}^{\infty}B_k\right).
反向不等式已经由次可加性保证。
因此两边相等。
这就证明可数并仍然可测。
所以
\boxed{\mathcal L\text{ 是一个 }\sigma\text{-代数}.}更进一步,利用类似的有限分割与极限论证,可以证明:
如果 A_1,A_2,\ldots\in\mathcal L 两两不相交,那么
\boxed{
m^*\left(\bigcup_{n=1}^{\infty}A_n\right)
=
\sum_{n=1}^{\infty}m^*(A_n).
}
因此,把外测度限制在 \mathcal L 上:
m=m^*|_{\mathcal L},便得到了一个真正的测度。
这正是我们一直寻找的东西。
5.8.2 为什么 Borel 集都会被包含进来?
还剩下一个重要问题。
这个构造是否至少能够测量区间?
答案是肯定的。
例如,考虑半直线
A=(-\infty,a).对于任意 E\subseteq\mathbb R,用开区间族覆盖 E,再把每个覆盖区间在 a 处分割成左右两部分。
两部分的长度之和仍然等于原区间的长度。
通过对这些覆盖的总长度取下确界,可以证明
m^*(E\cap A)+m^*(E\setminus A)\le m^*(E).另一方向由次可加性给出。
于是 A 可测。
同理,所有开区间都可测。
而因为 \mathcal L 是 \sigma-代数,所以
\boxed{
\mathcal B(\mathbb R)\subseteq\mathcal L.
}
这样,我们便完成了一件非常重要的事:
从区间长度出发,构造一个定义在足够丰富集合族上的、平移不变且可数可加的测度。
它就是 Lebesgue 测度。
5.8.3 Borel 集和 Lebesgue 可测集相同吗?
这里还有一件很容易被忽略的事情。
\mathcal B(\mathbb R)
\subsetneq
\mathcal L.
也就是说,Lebesgue 可测集合严格多于 Borel 集合。
为什么?
考虑经典的三分 Cantor 集 C。
它是闭集,因此是 Borel 集。
它不可数,但
m(C)=0.因为在第 n 步,保留下来的 2^n 个区间总长度为
\left(\frac23\right)^n,而这个长度趋于零。
更重要的是,在 Lebesgue 测度下,任何零测集的任意子集仍然可测,且测度为零。
因为如果 A\subseteq C,那么
0\le m^*(A)\le m^*(C)=0.从而 m^*(A)=0,而任何外测度为零的集合都自动满足 Carathéodory 可测性准则。
所以
\boxed{
A\subseteq C\implies A\in\mathcal L.
}
但 Cantor 集拥有与实数集相同的基数,其幂集的基数严格大于 Borel 集族的基数。 良基 Borel 编码与基数比较的完整论证见测度基础补证。
因此,必然存在一些 Cantor 集的子集不是 Borel 集,却是 Lebesgue 可测集。
这说明,Borel 测度可以进一步完成化(completion),将零测集合的所有子集纳入可测体系。 任意测度的完备化构造、最小性与唯一性见配套证明。
现在,我们终于有了严格意义上的连续均匀概率模型:
\boxed{
\begin{aligned}
\Omega&=[0,1],\\
\mathcal F&=\mathcal L|_{[0,1]},\\
P(A)&=m(A).
\end{aligned}
}
其中
\mathcal L|_{[0,1]}
=
\{A\subseteq[0,1]:A\in\mathcal L\}.
对任意 0\le a<b\le1,
P([a,b])=b-a.我们从一开始就希望建立的连续均匀概率,终于得到了严格的数学基础。
但付出的代价是:
\boxed{\mathcal F\ne\mathcal P([0,1]).}我们保留了自然的长度、平移不变性和可数可加性,却放弃了要求所有集合都可测的愿望。
这不是失败。
这是发现了正确的数学结构。
5.9 为什么概率必须具有可数可加性?
到目前为止,我们已经认识了 \sigma-代数与 Lebesgue 测度。
但是,还有一个重要问题没有回答。
既然有限可加性已经足够处理有限赌博,为什么要进一步要求可数可加?
也就是说,为什么仅仅满足
P(A\cup B)=P(A)+P(B)对于互斥的 A,B 成立,还不够?
这一次,我们不从历史出发,而是研究概率与极限之间的关系。
5.9.1 当事件越来越大时,概率应该怎样变化?
设
A_1\subseteq A_2\subseteq\cdots是一列递增的事件。
并令
A=\bigcup_{n=1}^{\infty}A_n.我们记作
A_n\uparrow A.假设 A_n 表示某个随机事件在前 n 次实验中至少发生过一次。
那么 A 表示它在整个无限实验过程中至少发生过一次。
如果前 n 次实验覆盖的时间越来越长,那么我们自然希望:
\boxed{
P(A_n)\longrightarrow P(A).
}
但这个结论不是单纯由有限可加性保证的。
我们来证明,可数可加性为什么能够保证它。
定义
B_1=A_1,B_n=A_n\setminus A_{n-1},
\qquad n\ge2.这些 B_n 两两不相交。
而且
A=\bigsqcup_{n=1}^{\infty}B_n.因此由可数可加性,
P(A)=\sum_{n=1}^{\infty}P(B_n).另一方面,由有限可加性,
P(A_n)=\sum_{k=1}^{n}P(B_k).让 n\to\infty,得到
\boxed{
A_n\uparrow A
\quad\Longrightarrow\quad
P(A_n)\uparrow P(A).
}
这称为测度的下连续性,或对递增集合序列的连续性。
对于递减的事件序列,
A_1\supseteq A_2\supseteq\cdots,若
A=\bigcap_{n=1}^{\infty}A_n,因为概率空间中的总测度有限,我们可以对补集应用刚才的结论,得到
\boxed{
A_n\downarrow A
\quad\Longrightarrow\quad
P(A_n)\downarrow P(A).
}
这称为测度的上连续性。
我们终于看到可数可加性的一种真正意义。
它保证,当事件通过可数次集合运算趋向某个极限事件时,概率能够与这种极限保持一致。
事实上,对有限测度而言,有限可加性再加上对递增集合序列的连续性,就足以推出可数可加性。
因此,这两者不是完全无关的数学要求。
可数可加性可以被理解成一种使概率与极限运算相容的原则。
5.9.2 一个不可能存在的“无限公平抽奖”
现在想象一种抽奖。
所有自然数
1,2,3,\ldots都可能成为中奖号码。
而且我们希望每个号码完全公平,具有相同概率。
设
P(\{n\})=c对所有 n 成立。
如果 c>0,则
P(\mathbb N)
=
\sum_{n=1}^{\infty}c
=\infty.
但我们要求
P(\mathbb N)=1.所以不可能有 c>0。
如果 c=0,则
P(\mathbb N)
=
\sum_{n=1}^{\infty}0
=0.
仍然矛盾。
因此:
\boxed{
\text{不存在定义在 }\mathbb N\text{ 上、}\\
\text{使所有单点等概率的可数可加概率测度。}
}
这里真正的问题不是自然数太多。
而是我们要求所有单点拥有相同概率,同时又要求全部自然数的概率为1。
如果允许概率随着号码变化,就没有困难。
例如:
P(\{n\})=2^{-n},
\qquad n=1,2,\ldots
因为
\sum_{n=1}^{\infty}2^{-n}=1.这一点值得思考。
第一章中,对称性曾经使我们得到均匀概率。
但现在,对称性却可能与可数可加性产生冲突。
并不是任何我们觉得公平的对称要求,都能够在无限概率空间中实现。
概率论必须明确区分:哪些对称性能够产生合法概率分布,哪些只能在其他数学框架中表达。
5.10 Kolmogorov:概率终于成为测度的一种特殊形式
现在,我们已经拥有了建立现代概率论所需要的主要数学结构。
一个结果空间 \Omega。
一个允许讨论概率的事件族 \mathcal F。
以及一个能够给这些事件赋予数值的函数 P。
于是我们终于可以正式写出:
定义 5.3:概率空间
一个概率空间是三元组
\boxed{(\Omega,\mathcal F,P)}其中:
\Omega 是非空样本空间;
\mathcal F 是 \Omega 上的 \sigma-代数;
P:\mathcal F\to[0,1] 满足
P(\Omega)=1,并且对于任意两两不相交的事件 A_1,A_2,\ldots\in\mathcal F,
\boxed{
P\left(\bigcup_{n=1}^{\infty}A_n\right)
=
\sum_{n=1}^{\infty}P(A_n).
}
这样,我们就得到了现代的 Kolmogorov 概率公理框架。
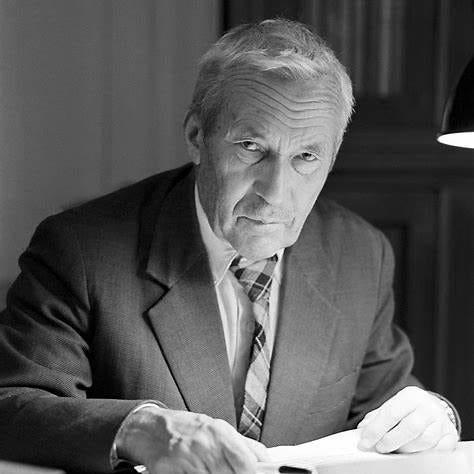
Andrey Kolmogorov(1903—1987)
1933年出版 Grundbegriffe der Wahrscheinlichkeitsrechnung(《概率论基础》),将概率论系统地建立在测度论公理框架之上。
这里也需要尊重历史。
Kolmogorov 并不是在1933年第一次发现概率可以与测度联系起来。此前 Borel、Lebesgue 及其他数学家的研究已经为这种联系奠定了基础。
但 Kolmogorov 的工作使这一框架获得了系统而清晰的表达,成为现代概率论的基本语言。〔48, 54〕
现在我们终于能够重新理解第一章的古典概率。
假设
\Omega=\{\omega_1,\ldots,\omega_n\},取
\mathcal F=\mathcal P(\Omega).定义
P(A)=\frac{|A|}{n}.那么它满足所有概率公理。
因此,古典概率不过是现代概率测度的一个特殊例子。
对于非等可能的有限结果空间,我们也可以选择
p_i\ge0,\qquad\sum_{i=1}^{n}p_i=1,然后定义
P(A)=\sum_{\omega_i\in A}p_i.对于无限可数空间,则可以使用可求和的权重序列。
对于连续空间,可以使用 Lebesgue 测度或者以它为基础构造的其他概率测度。
这时,我们突然发现:
\boxed{
\begin{gathered}
\text{古典等可能计数}\\
\text{非等可能离散概率}\\
\text{连续均匀概率}\\
\text{更一般的概率分布}
\end{gathered}
\quad
\begin{gathered}
\\[-1.5em]
\Bigg\}\\
\\[-0.5em]
\text{概率测度}
\end{gathered}
}
这些原本需要分别处理的数学对象,终于被统一起来。
但这种统一不是因为所有概率都能够化为计数。
恰恰相反。
计数只是测度的一种特殊形式。
这正是我们从第一章走到这里所完成的理论扩展。
5.11 为什么随机变量必须是可测函数?
现在,我们拥有了概率空间
(\Omega,\mathcal F,P).但概率论并不只研究事件。
我们还需要研究随机变量。
例如,掷三个骰子时,我们可能只关心点数之和:
X(\omega)=\text{三个骰子的总点数}.在有限空间中,任何这样的函数都可以直接处理。
但在一般的概率空间里,我们需要更加谨慎。
假设
X:\Omega\to\mathbb R是一个函数。
如果我们想研究事件
\{X\le a\},它实际上是
X^{-1}((-\infty,a]).为了能够计算它的概率,我们必须要求
X^{-1}((-\infty,a])\in\mathcal F.而且,我们不应该只处理这一类区间事件。
对于所有 Borel 集合 B,我们都希望能够计算
P(X\in B).所以必须要求:
X^{-1}(B)\in\mathcal F,
\qquad B\in\mathcal B(\mathbb R).
这就是随机变量可测性的来源。
定义 5.4:随机变量
设 (\Omega,\mathcal F,P) 是概率空间。
如果函数
X:\Omega\to\mathbb R满足
\boxed{
X^{-1}(B)\in\mathcal F
\quad
\text{对所有 }B\in\mathcal B(\mathbb R),
}
那么称 X 是一个实值随机变量。
注意,这个定义完全没有要求 X 的函数值本身具有某种特殊的随机形式。
它唯一要求的是:
通过 X 所提出的 Borel 事件,必须对应原概率空间中允许测量的事件。
于是我们才能严格定义 X 的分布:
\boxed{
P_X(B)=P(X^{-1}(B)).
}
这正是第一章中三个骰子的点数之和所预示的推前测度结构。
当时,我们只需要把216个有序结果按照它们的总和进行分组。
如今,我们发现相同的数学思想可以在一般概率空间中成立。
一个随机变量的分布,就是原概率测度在可测映射下产生的新测度。
5.11.1 回到 Brownian motion:为什么连续路径上的最大值可以被测量?
还记得第四章中我们研究过的事件吗?
A=\left\{
\omega:
\sup_{0\le t\le1}B_t(\omega)>1
\right\}.
我们现在终于可以严格解释它为什么是可测事件。
假设 Brownian motion 已经作为一个取值于 C([0,1]) 的随机元素构造出来。
对于任意连续函数 f,有
\boxed{
\sup_{0\le t\le1}f(t)
=
\sup_{t\in\mathbb Q\cap[0,1]}f(t).
}
为什么?
因为有理数在 [0,1] 中稠密,而 f 连续。
因此,尽管我们最初是在不可数多个时间点上取上确界,但对于连续路径,实际上只需要在可数多个有理时刻上取上确界。
于是
A=
\bigcup_{q\in\mathbb Q\cap[0,1]}
\{B_q>1\}.
这里使用了以下事实:若一组实数的上确界大于1,那么其中至少有一个数大于1。
而对于每个有理数 q,事件
\{B_q>1\}都是可测的。
因为 \mathbb Q\cap[0,1] 可数,所以
A\in\mathcal F.我们终于看到:
\sigma-代数对可数并的封闭性、实数中的可数稠密集,以及连续路径的性质,共同保证了某些复杂路径事件的可测性。
这些看似来自不同数学领域的性质,在这里结合得非常自然。
这也说明为什么第四章构造 Brownian motion 时,不能只给出各个时间点的正态分布,就宣称已经拥有完整的随机路径理论。
我们还需要可测性、函数空间结构,以及适当的路径正则性。
5.12 概率为1,究竟意味着什么?
还有一个我们此前不断使用、却从未认真解释的术语。
几乎必然(almost surely)。
例如,第四章中我们说:
Brownian motion 的路径几乎必然连续。
又说:
Brownian motion 的路径几乎必然处处不可导。
这究竟是什么意思?
现在我们可以给出严格定义。
如果一个事件 A\in\mathcal F 满足
P(A)=1,那么我们说 A 几乎必然发生。
如果
P(A)=0,我们说 A 是零概率事件。
需要注意:
P(A)=1并不意味着
A=\Omega.同样,
P(A)=0并不意味着
A=\varnothing.例如,在 [0,1] 上的均匀概率空间中,
P(X\in\mathbb Q)=0.但区间内当然有许多有理数。
因此,零概率不等于逻辑不可能。
而概率为1,也不等于不存在例外。
这种区分将成为现代概率论中非常重要的一种思想。
因为我们经常不需要要求某个性质对每一条样本路径都成立。
只需要证明它除了一个零概率集合之外,对所有结果都成立。
于是:
X_n\xrightarrow{\mathrm{a.s.}}X意味着
P\left(
\left\{\omega:
\lim_{n\to\infty}X_n(\omega)=X(\omega)
\right\}
\right)=1.
这里,我们又遇到了可测性。
要使这个概率表达式合法,集合
\left\{
\omega:
\lim_{n\to\infty}X_n(\omega)=X(\omega)
\right\}
必须属于 \mathcal F。
对于实值可测随机变量,这确实成立,因为收敛事件可以通过可数次并、交以及有理数阈值条件表达出来。
因此,几乎必然收敛不是一个单纯的极限概念,而是分析中的逐点收敛与测度论中的零测集思想结合起来的结果。
等到我们系统研究各种收敛方式时,这一点将成为理解它们区别的基础。
第五章结语:数学为什么必须学会放弃?
我们最初只是想做一件十分合理的事情。
在区间 [0,1] 中均匀地随机选择一个数字,并且希望对任何可能的事件计算概率。
为了实现它,我们试图建立一种可以测量所有集合大小的方法。
但无限集合迫使我们重新审视“大小”的概念。
首先,基数无法表示区间长度。
然后,我们发现,一个在空间中稠密的集合,完全可能具有零测度。
更重要的是,Vitali 的构造告诉我们:
在通常的集合论基础下,我们不可能同时保留所有原本希望拥有的性质。
于是我们不得不放弃“所有子集都应该可测”这一要求。
但这个限制并没有让理论变得贫乏。
恰恰相反。
我们通过 \sigma-代数,找到了一个既能够处理无限事件运算、又能够与可数可加性相容的可测体系。
通过外测度与 Carathéodory 可测性,我们从区间长度构造出了 Lebesgue 测度。
最终,Kolmogorov 的公理框架将古典概率、离散分布与连续概率统一起来。
回顾整条道路:
有限结果的计数
P(A)=\frac{|A|}{|\Omega|}无限集合中的大小问题 基数不再等同于长度
Vitali 的不可能性 不能在全部子集上同时满足所要求的性质
可测性与 \sigma-代数
\mathcal F\subseteq\mathcal P(\Omega)现代概率空间
(\Omega,\mathcal F,P)计数成为测度的特殊情况
我认为这一章最值得记住的,不应该只是概率空间的三个公理。
而是一个更深刻的思想:
数学理论的成熟,有时候不是因为我们获得了越来越多的自由,而是因为我们发现了哪些自由必须受到限制。
我们放弃了测量所有集合的要求,换来了一套能够处理无限、极限和复杂随机对象的严格理论。
可是,虽然我们现在已经拥有了概率测度,还有一个核心问题没有解决。
我们能够计算事件的概率:
P(A).但如果有一个随机变量
X:\Omega\to\mathbb R,我们究竟应该怎样计算它的平均?
在有限空间中,这很简单:
\mathbb E[X]
=
\sum_{\omega\in\Omega}X(\omega)P(\{\omega\}).
在连续分布中,我们又习惯写:
\mathbb E[X]
=
\int_{\mathbb R}x f_X(x)\,dx.
但如果随机变量既不具有离散分布,也不具有概率密度呢?
如果分布包含离散与连续的混合部分呢?
甚至,如果我们研究的是一个没有密度的奇异分布呢?
难道需要为每一种分布重新发明一种期望公式?
我们已经知道,概率是测度。
那么期望是否也存在一种统一的数学形式?
答案是:
\boxed{
\mathbb E[X]=\int_\Omega X\,dP.
}
但这个公式现在还只是一个尚待解释的承诺。
我们必须回答:
为什么积分能够统一所有这些平均?
如何从简单函数构造一般的积分?
为什么有些随机变量没有有限期望?
什么时候允许把极限放进期望符号?
这些问题将带领我们走向下一章。
第六章:平均值的重生——从加权求和到 Lebesgue 积分
我们将重新从第一章的公平赌金出发。
但这一次,我们不再把期望仅仅看作一种计算收益的方法。
我们要发现:
积分为什么是加权平均最自然的推广,以及为什么测度论最终需要一种与 Riemann 积分不同的积分方式。
单调收敛定理、Fatou 引理、控制收敛定理和 Fubini–Tonelli 定理,将在这个过程中逐步出现。
而我们也将为未来严格研究条件期望、鞅和各种收敛方式做好准备。
《偶然的数学》· 第二卷第五章 · 工作稿 v0.1