Haobai Wang · 公开阅读版 · ch13-zh-8c6c8bb2598c
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 8c6c8bb2598cf86b83678cd30c1978d300add82f77aaca43c252a0059531be0c
《偶然的数学》
第二卷 · 无限世界中的概率
第十三章:罕见事件为什么会产生新的稳定规律?
账本旁边,还放着一张只记事故的纸。
一笔异常收益可能使一条无穷级数无法收敛。但记录者也许只在每次异常出现时画一道短线。他不要求这些损失加成一个有限数,而想知道:在越来越长、每次机会又越来越小的实验中,纸上最后会有多少道线?
这两种观察没有矛盾。对于一条固定的无限记录,尾部事件可能反复到来;对于一批批重新规定规模的实验,单次机会可以随着总次数一起改变。真正需要安排的是两者之间的尺度。若把每一次机会都缩成零,会什么也不留下;若只增加次数而不减小机会,计数又会不断增大。我们要找的是那条让罕见与累积同时被看见的边界。
13.1 每一次都几乎没有,合起来却未必没有
先把事故的大小放在一旁。一次实验只记录是否发生,取值为0或1。在第 n 批中,做 n 次独立实验,每次发生的概率为 p_n,总次数记作 N_n。这里不是把同一条固定参数的记录无限延长,而是一列不同规模的实验设计;同一批内部独立,不要求不同批之间独立。
如果只说 p_n\to0,几乎没有告诉我们总计数。取 p_n=n^{-2},由 Markov 不等式,P(N_n>0)\le np_n\to0。取 p_n=n^{-1/2},计数的平均为 \sqrt n,它围绕这个不断增长的量聚集:Chebyshev 给出 P(|N_n-np_n|>np_n/2)\le4/(np_n)\to0。
两种情形之间,最值得停下来的是
p_n\longrightarrow0,\qquad np_n\longrightarrow\lambda\in(0,\infty).每次机会消失了,全部机会的预算却留下一个有限数。这个数不是最后一定发生的次数,而是对最后计数的平均要求。预算为3,不表示记录上必须恰好有3道线。
固定非负整数 k。当 n\ge k 时,二项公式可以写成
P(N_n=k)=\frac{n(n-1)\cdots(n-k+1)}{k!}\,p_n^k(1-p_n)^{n-k}
\longrightarrow e^{-\lambda}\frac{\lambda^k}{k!}.
这里有限个因子的乘积给出 \lambda^k/k!;而 \log(1-p_n)=-p_n+O(p_n^2),且 np_n^2=(np_n)p_n\to0,所以 (1-p_n)^n\to e^{-\lambda}。这说明最后没有发生事故的机会也不会消失:它趋向 e^{-\lambda}。
右侧确实构成一份概率,因为指数级数给出总和1。我们把它记作 \operatorname{Pois}(\lambda);当 \lambda=0,约定为集中在0的概率。逐项求和又得到
\mathbb EN=\lambda,\qquad \mathbb E[N(N-1)]=\lambda^2,\qquad \operatorname{Var}(N)=\lambda.固定 k 的极限并不是一句可以跳过尾部的形式计算。不过这里极限质量已经加起来等于1:选有限 K 使极限在 0,\ldots,K 的质量接近1,再用有限项收敛,就把两边的尾部同时压小。这不仅给出分布收敛,还会给出下一节要精确定义的更强距离收敛。
Poisson 的名字把我们带到1837年的《刑事与民事判决的概率研究》。它讨论的远不只是判决,也涉及 Bernoulli 试验在稀有事件情形下的近似。历史上的问题与今天的定义不能不加区分:下面的数组、耦合和距离估计是现代数学重建,不把整套理论归作原书已经具有的表达。原书英译与译者说明可帮助读者核对这种区别。
13.2 一条曲线接近,究竟允许我们怎样计算?
若只关心固定阈值,分布函数已经足够。但记录者可能换一种问法:次数是否为偶数?是否落在事先选定的一串整数中?如果每换一个事件,就要重新讨论近似是否成立,这份近似便还不够稳定。
对同一可测空间上的两份概率,定义总变差距离
d_{\mathrm{TV}}(\mu,\nu)=\sup_{A}|\mu(A)-\nu(A)|.它同时控制所有可测事件。本章采用这个归一化,距离在0与1之间;一些文献把相应的全变差范数定义成它的两倍,引用误差常数时必须分清。
若两份概率集中在同一个可数集合 E,写 a_x=\mu\{x\}-\nu\{x\}。因为 \sum_xa_x=0,正项之和等于负项绝对值之和。任意事件的差不超过正项之和,取全部正项的集合就达到它。因此
d_{\mathrm{TV}}(\mu,\nu)=\frac12\sum_{x\in E}|\mu\{x\}-\nu\{x\}|=1-\sum_{x\in E}\min(\mu\{x\},\nu\{x\}).这也补全了上一节的尾部论证:有限部分的绝对差趋零,剩余绝对差不超过两份尾部概率之和;然后令有限部分扩大。一般地,在同一个可数集合上,逐点质量收敛到一份总质量1的概率,就推出总变差收敛。
总变差还有一个很具体的解释。把两个随机结果 U,V 放进同一次实验中,只要它们相等,对任何事件的判断就相同。所以
|P(U\in A)-P(V\in A)|\le P(U\ne V),\qquad d_{\mathrm{TV}}(\mathcal L(U),\mathcal L(V))\le P(U\ne V).在可数空间里,甚至能让右侧恰好等于左侧的上确界。令 r_x=\min(\mu\{x\},\nu\{x\}),r=\sum_xr_x。以概率 r,按 r_x/r 抽取同一个结果;剩余概率中,分别按两份扣掉共同部分后的归一化概率抽取。两份残余的支撑不相交,因此在这一部分必定不同。若 r=0 或1,相应的空步骤略去即可。这是一个完整的耦合构造,而不只是“尽量把它们放在一起”的直觉。
于是,估计分布距离的问题变成:能否把真实实验与一个容易计算的实验放在一起,使它们很少产生不同记录?
13.3 让一次机会和一小份 Poisson 计数相遇
先只比较一格记录。令 B 服从 \operatorname{Bern}(p),Z 服从 \operatorname{Pois}(p),其中 0\le p\le1。在0处,e^{-p}\ge1-p;在1处,p\ge pe^{-p};在2及以上,只有 Poisson 概率有质量。Bernoulli 相对于 Poisson 唯一多出来的质量就在1处,故
d_{\mathrm{TV}}(\operatorname{Bern}(p),\operatorname{Pois}(p))=p(1-e^{-p})\le p^2.这个二次误差有一个机制:一次机会最多记一道线,小 Poisson 计数却允许同一格中出现两次以上。第一次量级的发生机会匹配了,差别被留到了更小的二次量级。准确的距离公式来自上面的质量比较,不把这种解释当成证明。
现在让 B_1,\ldots,B_m 独立,成功概率可以各不相同,记
N=\sum_{i=1}^mB_i,\qquad \lambda=\sum_{i=1}^mp_i.对每个 i 使用上一节的共同质量构造,把 B_i 与 Z_i\sim\operatorname{Pois}(p_i) 配成一对,再让这些成对实验彼此独立。第八章的有限乘积构造已经允许这样做。于是两列各自都具有所要求的独立性,而且
P\left(\sum_iB_i\ne\sum_iZ_i\right)\le P(\exists i:B_i\ne Z_i)\le\sum_i p_i(1-e^{-p_i})\le\sum_i p_i^2.独立 Poisson 之和仍为 Poisson。对两个参数直接卷积,在 k 处得到 e^{-(a+b)}\sum_{j=0}^k a^jb^{k-j}/(j!(k-j)!)=e^{-(a+b)}(a+b)^k/k!;有限次归纳便得到 \sum_iZ_i\sim\operatorname{Pois}(\lambda)。因此
\boxed{\ d_{\mathrm{TV}}(\mathcal L(N),\operatorname{Pois}(\lambda))\le\sum_i p_i(1-e^{-p_i})\le\sum_i p_i^2.\ }这就是本章使用的 Le Cam 型界。如果改用可数质量绝对差之和,右侧应乘2。它不要求各格概率相等,也不要求先取极限;任何有限实验,只要满足独立 Bernoulli 假设,就有这条具体误差界。上界超过1时当然仍然正确,只是没有提供有用精度。
Le Cam 的1960年论文以 Poisson binomial 分布的逼近为题,明确研究独立而可不同概率的 Bernoulli 和,并仔细选择测度距离。我们这里给出的是耦合证明及上述常数,不把它声称为该论文全部更强估计或原证明的复刻。原刊全文也提醒我们:定理的名称不能代替距离与常数的约定。
13.4 不同的小机会,为什么忘掉了自己的差别
把一批实验写成独立指标 B_{n1},\ldots,B_{nm_n},令 p_{ni}=P(B_{ni}=1)。只要求每一行内独立,记 N_n=\sum_iB_{ni}、\lambda_n=\sum_i p_{ni}。若
\max_{1\le i\le m_n}p_{ni}\longrightarrow0,\qquad \lambda_n\longrightarrow\lambda<\infty,那么所有概率平方的和至多为 \lambda_n\max_i p_{ni},因此趋零。不同大小的小机会,都在同一条二次误差账中失去了个别身份。
还要把参数 \lambda_n 换成 \lambda。若 a\le b,取独立的 U\sim\operatorname{Pois}(a)、D\sim\operatorname{Pois}(b-a),则 U+D\sim\operatorname{Pois}(b)。两者只有在 D>0 时才可能不同,所以
d_{\mathrm{TV}}(\operatorname{Pois}(a),\operatorname{Pois}(b))\le1-e^{-|a-b|}\le|a-b|.对事件差使用三角不等式,得到非同分布稀有事件极限的定量版本:
d_{\mathrm{TV}}(\mathcal L(N_n),\operatorname{Pois}(\lambda))\le\sum_i p_{ni}^2+|\lambda_n-\lambda|\longrightarrow0.例如 p_{ni}=2\lambda i/[n(n+1)],1\le i\le n,对充分大的 n 都是合法概率。它们从小到大并不相等,总和却恰为 \lambda,最大值为 2\lambda/(n+1)。误差至多 2\lambda^2/(n+1)。决定极限的不是每格相同,而是没有任何一格独占有限份额,同时全部机会预算收敛。
这里的“没有大的一格”甚至有一种必要性。仍假设 \lambda_n\to\lambda<\infty。如果 N_n 分布收敛到 \operatorname{Pois}(\lambda),在分布函数的连续点 -1/2,1/2 取差,得到 P(N_n=0)\to e^{-\lambda}>0。最终没有 p_{ni}=1,且
0\le\frac12\sum_i p_{ni}^2\le\sum_i[-\log(1-p_{ni})-p_{ni}]=-\log P(N_n=0)-\lambda_n\longrightarrow0.用到的不等式由 -\log(1-p)-p=\int_0^p u/(1-u)\,du\ge p^2/2 得到。因此 \max_i p_{ni}\to0。在总预算收敛这一前提下,稀疏性不是可有可无的装饰条件。
13.5 预算相同,为什么仍可能是另一份世界
保留一枚成功概率为 q\in(0,1) 的普通硬币,再加入许多总预算为 \lambda-q 的独立小机会,其中 \lambda>q。这枚普通硬币不会在极限中消失。总计数趋向独立的 \operatorname{Bern}(q)+\operatorname{Pois}(\lambda-q),而非 \operatorname{Pois}(\lambda):前者的零次概率为 (1-q)e^{-(\lambda-q)},与 e^{-\lambda} 不同。平均次数相同,不能抹掉一格中仍然可见的结构。
独立性也不能只写在背景里。取一个均匀变量 U,在第 n 行让全部 n 个指标都等于 \mathbf1_{\{U\le\lambda/n\}},其中 n\ge\lambda。每格概率趋零,总预算为 \lambda,但总计数不是散落的小事件,而是一次全体同时发生的巨大簇:
N_n=n\mathbf1_{\{U\le\lambda/n\}},\qquad N_n\longrightarrow0\ \text{in probability},\qquad \mathbb EN_n=\lambda.这恰好重现第七章尖峰的机制。极小概率承载越来越大的数量,平均没有跟着依概率极限一起走。Poisson 结论失败,不是因为机会不够小,而是它们没有独立地分散。
还有一种更温和的失败,反而会引出下一步理论。把 2n 个位置分成 n 对;每对以概率 \lambda/(2n) 同时发生,两对之间独立。每个位置都稀有,总预算仍为 \lambda,而总数趋向 2Z,其中 Z\sim\operatorname{Pois}(\lambda/2)。奇数永远没有质量。我们数到的不是独立单个事件,而是独立到来的双事件簇。
在三系定理中,大跳与小波动被分开;在这里,单个机会与成簇机会也必须分开。一个很小的边缘概率,既没有说明依赖方式,也没有说明一次发生究竟带来什么。
13.6 把一整列次数写进一个函数
对于非负整数随机变量 N,取 0\le z\le1,把计数写成
G_N(z)=\mathbb E z^N=\sum_{k=0}^\infty P(N=k)z^k,约定 0^0=1。这是概率母函数。它在这个区间总存在,因为 0\le z^N\le1;不需要假设任何阶矩有限。独立之和使母函数相乘,理由仍是第十一章的独立积分,但现在我们用的是衰减而非转动。
这个函数确实识别计数分布。先令 z\downarrow0 得到零次概率。若前 k 项已经确定,减去它们并除以 z^k,余下首项就是第 k 项系数,其后的尾部绝对值至多为 z\sum_{j>k}P(N=j)\le z。再次令 z\downarrow0,逐项恢复所有质量。这里不需要复分析中的幂级数唯一性定理。
Poisson 与 Bernoulli 的母函数分别为
G_{\operatorname{Pois}(\lambda)}(z)=e^{\lambda(z-1)},\qquad G_{\operatorname{Bern}(p)}(z)=1+p(z-1).于是独立稀有机会给出一个乘积,Poisson 给出一个指数。令 w=1-z,当最大概率趋零时,\log(1-p_{ni}w)=-p_{ni}w+O(p_{ni}^2w^2),总余项由平方预算控制。乘积只留下 e^{-\lambda w}。这把耦合中的机制换了一种读法:每格的一阶贡献可以累积,二阶碰撞在极限中消失。
但“函数值收敛”还需要一个不丢质量的极限工具。若 N_n=n,则对每个 z<1,G_{N_n}(z)\to0,而在1处始终为1。不存在一个有限整数值随机变量具有这样的母函数。概率逃向了无穷大;只看区间内部的逐点极限会把它全部漏掉。
为了在下一节处理大小不同的损失,我们把这份衰减读数扩大到所有非负实数。母函数并不是一个孤立的新技巧,它已经站在另一种变换的门口。
13.7 不让大数值爆炸的另一种读数
计数以外,事故还可能附带非负的损失。正指数会放大远处的结果,第十一章已经解释它为什么可能没有期望。若反过来,让大结果的贡献衰减,就得到非负随机变量的 Laplace 变换:
L_X(s)=\mathbb E e^{-sX},\qquad s\ge0,\quad 0\le X<\infty\ \text{a.s.}它总在0与1之间;由 DCT,L_X(s)\to1 当 s\downarrow0。独立非负量相加,使变换相乘。对整数计数,L_N(s)=G_N(e^{-s})。这些等式没有假设均值存在,更没有通过不存在的矩展开偷换积分。
为什么仅用衰减读数,就能识别整份概率?令 Y=e^{-X}\in(0,1]。知道全部 L_X(s),尤其知道整数 s=k 时的值,就知道 Y 在紧区间上的全部整数阶矩。第十一章曾警告“所有矩也未必识别分布”,但现在支撑被压进一个共同的紧区间;这项改变正是关键。
现在需要把一串矩读数接到任意连续观察上。多项式的积分已经由这些矩决定;若连续函数都能被多项式一致逼近,相同的矩就会迫使所有连续观察具有相同的平均。Bernstein 多项式把这座桥写成一个二项平均:抽样点集中在给定位置附近,平均读数也就逼近该处的函数值。
我们给出所需的逼近工具,而不把“紧区间上的矩问题”当作外借黑箱。对 [0,1]^d 上连续函数 g,定义 Bernstein 多项式
B_mg(y)=\sum_{k_1,\ldots,k_d=0}^m g(k_1/m,\ldots,k_d/m)\prod_{j=1}^d\binom m{k_j}y_j^{k_j}(1-y_j)^{m-k_j}.对固定 y,它就是 g(K_1/m,\ldots,K_d/m) 的平均,其中 K_j 独立且为参数 (m,y_j) 的二项变量。连续函数在紧立方体上一致连续。给定 \varepsilon>0,选 \delta>0,使坐标最大差不超过 \delta 时函数值差不超过 \varepsilon。Chebyshev 与并集界给出
\sup_y|B_mg(y)-g(y)|\le\varepsilon+2\|g\|_\infty\frac{d}{4m\delta^2}\longrightarrow\varepsilon.再令 \varepsilon\downarrow0,就证明了多项式的一致逼近。若两份立方体概率具有相同的全部混合矩,它们对多项式、因而对所有连续函数有相同积分。用连续下降斜坡逐点逼近每个闭下矩形的指标,再用 DCT,得到这些矩形的概率相同;闭下矩形组成生成 Borel 集的 \pi-类,\pi–\lambda 定理便给出两份概率相同。
具体的斜坡可以取 \prod_j[1-m(y_j-a_j)_+]_+,在立方体上趋向 \mathbf1_{\{y_j\le a_j,\ \forall j\}}。因此没有略去边界原子。把相同分布经可测逆变换 x_j=-\log y_j 拉回,便证明了有限非负向量的 Laplace 唯一性:
\mathbb E e^{-\sum_{j=1}^d s_jX_j}=\mathbb E e^{-\sum_{j=1}^d s_j\widetilde X_j}\quad(\forall s_j\ge0)
\quad\Longrightarrow\quad \mathcal L(X)=\mathcal L(\widetilde X).
这里说的是有限维向量,变换作用于有限个坐标。它没有预先建立一般点过程的 Laplace 泛函理论。
13.8 极限读数怎样保证概率没有逃走
唯一性回答“若有答案,它是否唯一”;极限问题还要保证答案存在,并保证衰减没有把逃向无穷大的质量藏起来。对非负实变量,一个直接的尾部估计是
P(X>M)\le\frac{1-L_X(s)}{1-e^{-sM}},\qquad s>0,\ M>0.因为在 X>M 上,1-e^{-sX}\ge1-e^{-sM}。它与第十一章的低频紧性估计具有同一作用:靠近原点的读数,控制很远处的质量。
这时有两道不同的关口。Bernstein 逼近让我们在紧立方体上从矩的收敛走到连续观察的收敛;但从衰减读数还原原来的数值时,靠近零的区域会被放大成远处的尾部。刚才的尾界正好守住这道出口。下面的证明把这两部分接起来,而不是仅凭变换收敛就宣告分布收敛。
先陈述一个不含存在歧义的有限维结论。若 X_n,X 都是几乎必然有限的非负 d 维向量,那么
X_n\Rightarrow X\quad\Longleftrightarrow\quad L_{X_n}(s)\longrightarrow L_X(s)\quad(\forall s\in[0,\infty)^d).这里的分布收敛指对所有有界连续函数的期望收敛。正向因为指数函数有界连续。反向先置 Y_{nj}=e^{-X_{nj}}、Y_j=e^{-X_j}。混合矩收敛,使每个多项式的期望收敛;上一节的一致逼近再使每个立方体连续函数的期望收敛。
还不能立刻对 -\log 使用同一个理由,它在0处无界。对每个坐标使用尾部估计。先取小的 s>0,利用 L_X(se_j)\to1,再取大的 M 使分母接近1,就得到 \limsup_nP(\max_jX_{nj}>M) 任意小;X 的相应尾部也任意小。这里用有限次并集,而不需要无限维紧性定理。
对任意有界连续 f,在 y_j\ge e^{-M} 的区域使用 f(-\log y_1,\ldots,-\log y_d),并把它连续截断到整个立方体:先把每个 y_j 替成 \max(y_j,e^{-(M+1)}),再乘上在 y_j\le e^{-(M+1)} 为0、在 y_j\ge e^{-M} 为1的连续斜坡之积。所得函数连续有界,在全部 X_j\le M 时等于 f(X)。两边期望的截断误差各至多为 2\|f\|_\infty 乘相应尾部概率。先令 n\to\infty,再把尾部压到零,就完成反向证明。
对实变量还可以不给出候选随机变量:若 L_{X_n}(s)\to L(s) 对所有 s\ge0 成立,L(0)=1,且 L 在0右连续,那么确有唯一的有限非负极限分布。上面的尾界先保证 \{\mathcal L(X_n)\} 一致紧:极限读数控制最终所有 n,有限个开头的尾部再分别扩大窗口处理。第十一章的实线选择论证便给出任意子序列的弱收敛子序列。
这些子序列极限仍非负:取有界连续函数 \min(1,(-x)_+),其积分只能为0。用有界连续延拓 e^{-s\max(x,0)} 测试,极限的 Laplace 变换为 L。唯一性使所有子序列极限相同;若某个有界连续测试的期望不收敛,抽出与该极限保持固定距离的子序列,再抽收敛子序列,就产生矛盾。这证明整列收敛,没有预用一般 Prokhorov 定理。
因此,若概率母函数的逐点极限在1处连续并取值1,就有一个有限整数值的极限。先令 s=-\log z 使用刚才的实线结论;再测试有界连续函数 \min(1,\operatorname{dist}(x,\mathbb N_0)),可知极限仍支撑在 \mathbb N_0。逐点质量收敛于是又升级为总变差收敛。原点或端点附近的连续性,阻止了那列 N_n=n 的“全体逃走”。
13.9 一道短线背后,可能是一笔不同大小的损失
现在给每次事故附上一个标记 J。先取有限或可数个实数作为可能标记,概率记为 Q。它可以表示损失大小,也可以表示不同种类的事故;标记的概率必须由模型给出,不能从“事故很稀少”自动推出。
取 N\sim\operatorname{Pois}(\lambda),独立于一列 i.i.d. 标记 J_1,J_2,\ldots,定义
S=\sum_{r=1}^N J_r,\qquad \sum_{r=1}^0J_r=0.第八章已经构造所需乘积空间;N 几乎必然有限,因此这个和不需要再次调用随机级数收敛定理。其分布称为复合 Poisson 分布。我们先有随机个数,再为每个出现附上独立标记;两个随机层次必须分清。
记 \phi_Q(t)=\mathbb E e^{itJ}。按 N 分组积分,绝对值至多1,使各步骤合法,得到
\mathbb E e^{itS}=\sum_{k=0}^\infty e^{-\lambda}\frac{\lambda^k}{k!}\phi_Q(t)^k
=\exp\{\lambda(\phi_Q(t)-1)\}.
如果标记非负,同样得到 L_S(s)=\exp\{\lambda(L_J(s)-1)\}。若标记为非负整数,母函数版本为 G_S(z)=\exp\{\lambda(G_J(z)-1)\}。这是同一个随机构造的三种读数,而不是分别猜出的三个定义。
当 \mathbb E|J|<\infty,条件期望给出 \mathbb ES=\lambda\mathbb EJ;当 \mathbb EJ^2<\infty,条件方差分解给出
\operatorname{Var}(S)=\lambda\operatorname{Var}(J)+\lambda(\mathbb EJ)^2=\lambda\mathbb EJ^2.标记恒为1,就回到普通 Poisson;标记恒为2,就得到上一节独立双事件簇的极限。损失的随机性与事故次数的随机性共同形成方差,所以不能只写成 \lambda\operatorname{Var}(J)。若标记没有这些矩,分布及有界变换仍然存在,矩公式却不能不加条件地使用。
若原来每个独立 Bernoulli 机会发生时都附上一枚与发生指标独立、同分布为 Q 的标记,给定总计数后,被选中的标记仍是独立的 Q 抽样。把总计数与对应 Poisson 计数作前面的耦合,并给它们使用同一列独立标记;计数相同时两个总和必定相同。因此
d_{\mathrm{TV}}\left(\mathcal L\left(\sum_iB_iJ_i\right),\mathcal L\left(\sum_{r=1}^{N}J_r\right)\right)\le\sum_i p_i^2,\qquad N\sim\operatorname{Pois}\left(\sum_i p_i\right).这条误差界不需要标记有均值或方差。它控制的是两次实验是否记录同一份总损失,而不是先比较两个也许不存在的平均值。
13.10 分成不同颜色以后,为什么仍能独立计数
让每次出现独立地获得颜色,颜色概率为 q_1,\ldots,q_r,余下颜色并成一类,概率为 q_0=1-\sum_{j=1}^r q_j。令 C_j 为第 j 类的次数。给定 N,这些计数受总数约束,并不独立;但把随机总数也平均掉,约束竟然消失了。
固定 k_1,\ldots,k_r,把其余类的次数 k_0 求和。条件于总数的多项式计数给出
P(C_1=k_1,\ldots,C_r=k_r)
=e^{-\lambda}\prod_{j=1}^r\frac{(\lambda q_j)^{k_j}}{k_j!}\sum_{k_0=0}^\infty\frac{(\lambda q_0)^{k_0}}{k_0!}
=\prod_{j=1}^r e^{-\lambda q_j}\frac{(\lambda q_j)^{k_j}}{k_j!}.
所以各颜色的计数独立,且为 \operatorname{Pois}(\lambda q_j)。零颜色概率按 0^0=1 解释。对可数个颜色,任取有限组,把其他颜色合并再做同一个计算,就证明全部有限组的独立性;总计数有限,仍只有有限个颜色会实际出现。
这是独立标记的分裂性质。它不是说任何 Poisson 总数都自动拥有独立的分类计数。若所有事故共用同一枚随机颜色硬币,总数虽为 Poisson,红蓝两类却不会同时非空;独立标记的条件已经失败。
对原来的稀有实验,也可逐格耦合 Bernoulli 与小 Poisson 计数;在每格准备一列独立标记,两边计数相同时使用相同标记。全部格都匹配时,所有颜色计数同时匹配。故同一平方预算控制的是整份分类记录的总变差误差,不只是每个颜色分别的误差。有限组颜色同时逼近独立 Poisson,不能仅由“各自边缘趋向 Poisson”推出;这里的共同耦合正好提供了缺少的联合论证。
13.11 标记也随着实验改变时,什么必须留下来
不同机会可能附带不同损失。第 n 行第 i 格发生概率为 p_{ni},独立标记规律为 Q_{ni},每格内指标与标记独立,且不同格的整对实验相互独立。仍限一个固定可数实数集合 E 中的标记,定义有限的强度账
\nu_n\{a\}=\sum_i p_{ni}Q_{ni}\{a\},\qquad a\in E,\qquad \nu_n(E)=\lambda_n.把每格 Bernoulli 换成参数 p_{ni} 的 Poisson,再保留那一格的标记规律。上面的逐格耦合使总损失的误差至多 \sum_i p_{ni}^2。替换后的特征函数为
\exp\left\{\sum_i p_{ni}(\phi_{Q_{ni}}(t)-1)\right\}
=\exp\left\{\sum_{a\in E}(e^{ita}-1)\nu_n\{a\}\right\}.
若 \lambda_n>0,这正是总次数参数 \lambda_n、单次标记分布 \nu_n/\lambda_n 的复合 Poisson 读数;第十一章实线唯一性识别两份总和规律。若 \lambda_n=0,总和恒为0。有限强度使级数绝对收敛,不需要一般 Poisson 随机测度。
设有有限测度 \nu 满足 \nu_n\{a\}\to\nu\{a\} 对每个 a\in E 成立,且 \lambda_n\to\nu(E)<\infty。选一个有限标记集合,使 \nu 的余下质量小;有限部分逐项收敛,总质量也收敛,于是余下质量同时小。这证明
\|\nu_n-\nu\|_1:=\sum_{a\in E}|\nu_n\{a\}-\nu\{a\}|\longrightarrow0.两份有限强度可按共同部分 \min(\nu_n\{a\},\nu\{a\}) 和两份残余分开构造独立的复合 Poisson 和。共同部分使用相同实验;两个残余的总强度之和为 \|\nu_n-\nu\|_1。只要两份残余都没有发生,最后总和便相同,因此两份复合 Poisson 规律的距离至多为 1-e^{-\|\nu_n-\nu\|_1}。各强度相加确实恢复相应规律,可直接用上一行特征指数及唯一性验证。结合逐格误差,得到
d_{\mathrm{TV}}\left(\mathcal L\left(\sum_iB_{ni}J_{ni}\right),\operatorname{CP}(\nu)\right)
\le\sum_i p_{ni}^2+\|\nu_n-\nu\|_1.
其中 \operatorname{CP}(\nu) 表示刚才以总强度与归一化标记构造的规律。条件 \max_i p_{ni}\to0 与有界总预算使第一项趋零;标记账的质量不逃走,使第二项趋零。两项有不同的责任。
如果每次标记都改成 n,总次数参数始终为 \lambda>0,总损失为 S_n=nN。任意固定 M,当 n>M 时都有 P(S_n>M)=1-e^{-\lambda},因此不一致紧。它的 Laplace 变换对每个 s>0 趋向 e^{-\lambda},在0处却为1。次数留下了,大小逃走了。不能只核对总强度,就宣称总损失也有有限极限。
13.12 当事故不再只有几次,钟形曲线怎样重新出现
Poisson 与 Gaussian 并不是两种互不相干的世界。对于 N_\lambda\sim\operatorname{Pois}(\lambda),当 \lambda\to\infty,考察中心化、标准化后的特征函数:
\mathbb E\exp\left\{it\frac{N_\lambda-\lambda}{\sqrt\lambda}\right\}
=\exp\left\{\lambda\left(e^{it/\sqrt\lambda}-1-\frac{it}{\sqrt\lambda}\right)\right\}
\longrightarrow e^{-t^2/2}.
固定 t 时,指数的余项为 O(|t|^3/\sqrt\lambda);第十一章 Lévy 连续性定理因而给出标准 Gaussian 极限。先在每个小格保留有限总次数,得到 Poisson;再让这些次数的预算增大,并观察中心波动,就重新看见钟形。
对二项实验,如果 np_n\to\infty 且 np_n^2\to0,Le Cam 界先把它在总变差中换成参数 np_n 的 Poisson,再把计数减去 np_n、除以 \sqrt{np_n},也得到 Gaussian 弱极限。后一个平方条件是这条两步证明的充分条件,不是二项 CLT 的必要条件;固定 p\in(0,1) 的二项 CLT 早已表明这一点。不能把一种逼近方法的局限误写成分布极限本身的边界。
但纸上的一道线,最后总是一个整数。如果读者问“恰好发生 k 次的机会是多少”,Gaussian 弱收敛还没有回答。它给固定标准化区间的概率,而一个整数点在标准化后只占宽度约 1/\sqrt n 的小格。这个格随着实验缩小,不能把固定测试的极限直接代进去。
13.13 极限曲线没有看见的空格
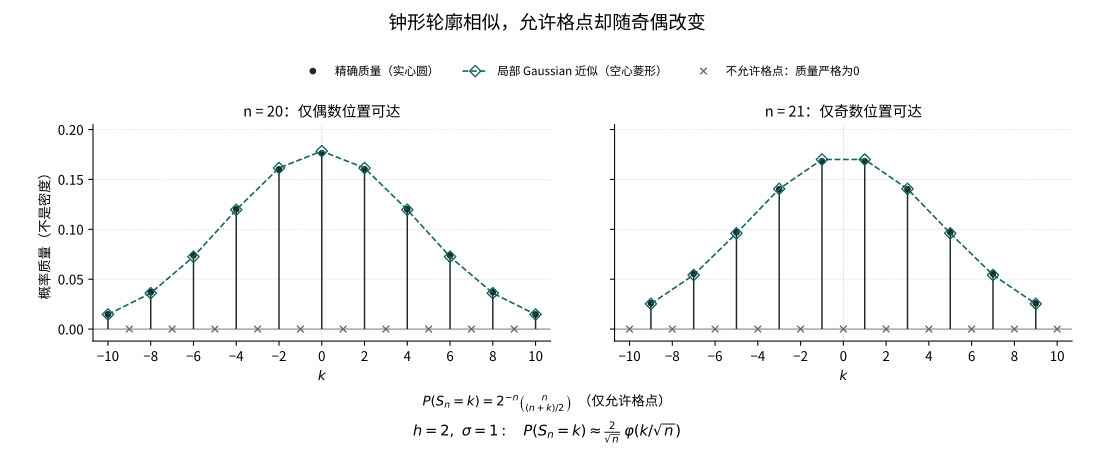
取最简单的对称随机游走,每一步为 -1 或1。第十一章已经证明,位置除以 \sqrt n 后趋向标准 Gaussian。但第 n 步的位置与 n 具有相同奇偶性:奇数时刻不可能站在0,偶数时刻也不可能站在1。
Gaussian 密度在这些点附近都严格为正。若把密度乘上整数格的宽度,机械地当成单点概率,一半格子上会立刻出错。弱收敛看见大尺度的钟形,却不负责填满本来不存在的格子。
还有一个更强的区别。令 \mu_n 为任一这种标准化格点和的分布,\gamma 为标准 Gaussian 概率。取 \mu_n 的可数支撑 A_n,它在 \mu_n 下概率为1,在 \gamma 下概率为0。所以即使弱收敛成立,仍有
d_{\mathrm{TV}}(\mu_n,\gamma)=1\qquad(n\ge1).这不与 Le Cam 界冲突。那里的比较双方都生活在同一整数计数空间;这里一方离散,一方连续。我们需要一种尊重格子宽度的局部近似,然后才能讨论适当离散化以后的总变差。
13.14 格点的真正间距,藏在频率的哪里
1948年,Gnedenko 在《Uspekhi Matematicheskikh Nauk》3卷3(25)期发表了《On a local limit theorem of the theory of probability》,页187–194,见原刊书目档案。局部极限所追问的,是整体钟形轮廓之下每一个允许格点究竟分到多少质量。下面从格点跨度与 Fourier 反演重新建立这一结论;这是本书的现代证明重建,并非对1948年原文证明的复述。
设 X 的分布支撑在 a+h\mathbb Z,其中 h>0。如果即使另选起点,所有更大的正间距也不能再容纳同一支撑,就称 h 为最大格点跨度。我们只讨论非退化分布;常数变量没有这里所需的有限最大跨度与正方差。
置 Y=(X-a)/h,则 Y 为整数值。最大跨度意味着支撑中所有整数差的最大公约数为1:否则支撑包含在某个更稀的整数剩余类中,X 的跨度还可以扩大。这些差中有有限多个整数线性组合为1,理由是不断加入差时,正的最大公约数只能下降有限次,最后再用 Euclid 算法。
令 \phi_Y(t)=\mathbb E e^{itY}。一个模为1的随机变量,其平均仍具有模1,当且仅当它几乎必然为同一常数;因为 \mathbb E|Z-\mathbb EZ|^2=1-|\mathbb EZ|^2。因此 |\phi_Y(t)|=1 时,支撑任意两点之差 d 都满足 td\in2\pi\mathbb Z。把有限个这样的差作整数线性组合,便得到 t\in2\pi\mathbb Z。于是
|\phi_Y(t)|<1\quad(0<|t|\le\pi),\qquad
\sup_{\delta\le|t|\le\pi}|\phi_Y(t)|=\rho_\delta<1\quad(0<\delta<\pi).
最后一步用特征函数连续性及紧集取最大值。这里并不是额外假设0必须在支撑中。例如 \{-1,1\} 的原变量跨度为2,换成 Y=(X+1)/2\in\{0,1\} 后才有跨度1;每个和所在的格点还会随 n 平移。
整数概率还有一个精确的反演公式。对整数值 T,有限区间上有界可积,Fubini 给出
P(T=k)=\frac1{2\pi}\int_{-\pi}^{\pi}e^{-itk}\phi_T(t)\,dt,因为对每个整数 j,(2\pi)^{-1}\int_{-\pi}^{\pi}e^{it(j-k)}\,dt 在 j=k 时为1,其余为0。这个反演只需一个有限频率区间。最大跨度又保证:除了原点以外,这个区间没有其他模为1的读数能长期存活。
13.15 从整个频率区间恢复一个格子的概率
现在可以准确陈述有限方差的格点局部中心极限定理。令 X_1,X_2,\ldots 为 i.i.d.,均值 \mu,方差 0<\sigma^2<\infty,支撑在 a+h\mathbb Z,且 h 是最大跨度。写 S_n=\sum_{j=1}^nX_j,并令
x_{nk}=\frac{na+hk-n\mu}{\sigma\sqrt n},\qquad
\varphi(x)=\frac1{\sqrt{2\pi}}e^{-x^2/2}.
则有一致于所有整数 k 的结论
\boxed{\ \sup_{k\in\mathbb Z}\left|\frac{\sigma\sqrt n}{h}P(S_n=na+hk)-\varphi(x_{nk})\right|\longrightarrow0.\ }它不要求第三阶矩,不要求有限支撑,也不要求每一个格点本来都有正质量。最大跨度的作用是消除真正的周期障碍;有限方差的作用是控制原点附近的二次形状。这两项假设解决不同的问题。
证明先把单位调到整数格。置 Y_j=(X_j-a)/h,其均值为 b=(\mu-a)/h,标准差为 v=\sigma/h>0,中心化特征函数为 \chi(t)=\mathbb E e^{it(Y_1-b)}。第十一章在有限二阶矩下已证明
\chi(t)=1-\frac{v^2t^2}{2}+o(t^2),\qquad
\chi\left(\frac{u}{v\sqrt n}\right)^n\longrightarrow e^{-u^2/2}\quad(u\in\mathbb R).
把上一节反演用于 Y_1+\cdots+Y_n,再换元 u=v\sqrt n\,t,就得到
v\sqrt n\,P(S_n=na+hk)=\frac1{2\pi}\int_{-\pi v\sqrt n}^{\pi v\sqrt n}e^{-iux_{nk}}\chi\left(\frac{u}{v\sqrt n}\right)^n\,du.另一方面,第十一章 Gaussian 反演的归一化为
\varphi(x)=\frac1{2\pi}\int_{\mathbb R}e^{-iux}e^{-u^2/2}\,du.两式现在只有振幅不同,振荡部分的模始终为1。如果证明两个振幅在整个实线上的 L^1 距离趋零,就能同时控制每一个格点,而不是对每个 k 单独取极限。局部定理所多付出的数学成本,正是这一份全频率积分控制。
13.16 原点附近留下形状,远处频率被独立相乘消去
由刚才的二阶展开,|\chi(t)|^2=1-v^2t^2+o(t^2)。因此可选 \delta\in(0,\pi),使 |t|\le\delta 时
|\chi(t)|\le e^{-v^2t^2/4},\qquad
\left|\chi\left(\frac{u}{v\sqrt n}\right)^n\right|\le e^{-u^2/4}\quad(|u|\le\delta v\sqrt n).
例如先使平方模至多为 1-v^2t^2/2,再用 1-r\le e^{-r} 并开平方,就得到第一式。近原点的振幅因此被同一个可积函数控制,而不是只知道其模不超过1。后一种界在长度不断增长的积分区间上不够使用。
对每个固定 u,近原点区间最终包含它,振幅趋向 e^{-u^2/2}。DCT 因而给出
\int_{\mathbb R}\left|\mathbf1_{\{|u|\le\delta v\sqrt n\}}\chi\left(\frac{u}{v\sqrt n}\right)^n-e^{-u^2/2}\right|\,du\longrightarrow0.控制函数可取 e^{-u^2/4}+e^{-u^2/2},在整个实线上可积。一般积分与 DCT 的基础补证保证这一用法不要求 Lebesgue 测度本身有限。
剩下 \delta v\sqrt n<|u|\le\pi v\sqrt n 的频率。最大跨度给出上一节的 \rho_\delta<1,而中心化不改变模,所以
\int_{\delta v\sqrt n<|u|\le\pi v\sqrt n}\left|\chi\left(\frac{u}{v\sqrt n}\right)\right|^n\,du
\le2\pi v\sqrt n\,\rho_\delta^n\longrightarrow0.
把这份远处估计与近处 L^1 收敛合并,得到整个截断振幅与 Gaussian 振幅的 L^1 距离趋零。反演公式的差绝对值不超过该距离除以 2\pi,而这个界完全不依赖 x_{nk}。取全部整数 k 的上确界,局部 CLT 便得到完整证明。
证明的两个部分不能互相替代。弱 CLT 使用固定频率在缩放后的行为;局部 CLT 还必须压住整个反演区间的其余频率。周期性恰好会在远处留下模为1的点,使这一压制失效。
13.17 奇数格子为什么不能被正态曲线填满
对固定 p\in(0,1) 的独立 Bernoulli 和,最大跨度为1,局部 CLT 给出
P(\operatorname{Bin}(n,p)=k)=\frac1{\sqrt{np(1-p)}}\varphi\left(\frac{k-np}{\sqrt{np(1-p)}}\right)+o(n^{-1/2}),其中余项一致于所有整数 k。这为第三章二项钟形的局部近似提供现代有限方差框架;它没有重讲第三章的历史推导,也没有替那一章所有误差速度作未经证明的承诺。这里 p 固定,不能把同一个定理无条件套到随 n 改变的稀有参数。
对 X_j=\pm1 的对称游走,取 a=-1、h=2、\sigma=1。因此只在 k\equiv n\pmod2 的位置上有
P(S_n=k)=\frac2{\sqrt n}\varphi\left(\frac{k}{\sqrt n}\right)+o(n^{-1/2}).不符合奇偶性的格子,其概率严格为0。特别是,n 为偶数时 \sqrt nP(S_n=0)\to2\varphi(0),n 为奇数时该量恒为0。若误把最大跨度写成1,连中心点都会得到错误常数。缺少的一半位置并没有丢掉概率,而使允许位置上的质量加倍。
这也解释为什么不能从弱 CLT 相减两个分布函数就结束局部证明。单点概率需要尺度为 n^{-1/2} 的精度;没有速率的分布函数误差,即使趋零,也可能大于单点概率本身。Fourier 的全区间控制提供了真正缺少的那一层信息。
13.18 如果要总变差,就先让两边生活在同一张格纸上
把 Gaussian 概率也分配到同一格纸,连续与离散的冲突才会消失。令 d_n=h/(\sigma\sqrt n),并定义整数标签上的概率
q_n(k)=\int_{x_{nk}-d_n/2}^{x_{nk}+d_n/2}\varphi(u)\,du.将这些小区间统一取为左闭右开,它们便互不相交地铺满实线,所以 \sum_kq_n(k)=1。这不是给某个 Gaussian 点赋予正概率,而是把整个小区间的质量归给一个格点。
记 p_n(k)=P(S_n=na+hk)。Gaussian 密度一致连续,故 \sup_k|q_n(k)/d_n-\varphi(x_{nk})|\to0。与局部 CLT 合并,有 \sup_k|p_n(k)-q_n(k)|/d_n\to0。但仍不能直接把无限多个一致小误差相加。
固定 R>0,中心区域 |x_{nk}|\le R 至多有 2R/d_n+2 个格点,所以这一部分的绝对差之和趋零。区域之外,Chebyshev 给出 \sum_{|x_{nk}|>R}p_n(k)\le R^{-2};对于 q_n,相应小区间全落在 |u|>R-d_n/2 中,尾和至多为该 Gaussian 尾概率。于是
\limsup_n d_{\mathrm{TV}}(p_n,q_n)\le\frac12\left(R^{-2}+\int_{|u|\ge R}\varphi(u)\,du\right).再令 R\to\infty,得到离散和与离散化 Gaussian之间的总变差趋零。中心区域靠局部精度,外面靠尾部预算;缺少任何一部分,都不能把逐点或局部估计升级成总变差。
我们现在可以准确分开三种结论:弱收敛比较有界连续观察;局部 CLT 比较单个格子的质量与密度乘格宽;总变差比较同一空间内的所有事件。它们相互联系,却不是三种写法的同一句话。
13.19 哪些条件不能悄悄拿走
有限方差在局部证明里留下了可积的 Gaussian 控制,它不是为了方便计算才附上的假设。看一个对称的整数分布:对 k\ge1,令 P(X=k)=P(X=-k)=c k^{-5/2},其中 c 使总概率为1。它有有限一阶绝对矩、均值0,二阶矩却为无穷;支撑差的最大公约数仍为1。
其特征函数为实数。对小的 |t|>0,只取 1/|t|\le k\le2/|t| 的项,1-\cos(kt) 有共同正下界,这段有量级 1/|t| 个整数,便得到某个常数 C>0 使
1-\phi_X(t)=2c\sum_{k\ge1}\frac{1-\cos(kt)}{k^{5/2}}\ge C|t|^{3/2}.连续性使 \phi_X(t) 在原点附近为正。因此对固定非零 u,独立和在平方根尺度上的特征函数满足
0\le\phi_X(u/\sqrt n)^n\le\exp\{-C|u|^{3/2}n^{1/4}\}\longrightarrow0.在0处却始终为1。这不可能是一份有限弱极限的连续特征函数,因而这列平方根标准化和甚至没有有限弱极限,更谈不上刚才的 Gaussian 局部结论。第十二章的一阶强律仍然适用。稳定平均与正确波动尺度,再次分出了不同责任。
最大跨度之外,格点本身也是本章局部陈述的范围。若 X 等可能取 0,1,\sqrt2,它非格点、有界且方差为正,有限方差弱 CLT 仍成立;然而每个有限和都只有有限个原子,没有 Lebesgue 密度。不能直接宣称其密度逐点趋向 Gaussian。非格点的小区间局部定理与密度局部定理有不同陈述及附加条件,不是把本章公式里的 h 擦掉。
此外,本章局部 CLT 的误差是绝对误差,并未证明所有远尾的相对误差趋零,也未给出仅由有限方差保证的统一收敛速度。二项和在支撑以外的概率恒为0,Gaussian 密度却仍为正;这已足以阻止把一致绝对近似误读成处处有效的相对近似。
第十三章结语:稀少的事情,并没有被平均掉
纸上的短线终于不再只是账本旁边的例外。单次机会变小,并不意味着它们从长记录中消失。只要总预算留下有限值,而没有哪一格或哪一个依赖簇偷偷占据过大份额,最后的计数便保留一份可识别的随机规律。
如果每道短线还带着损失大小,就不能只记有几道。标记把发生与后果分开;共同部分的耦合说明哪些微小差别会消失;靠近原点的衰减读数则提醒我们,计数留下以后,大小仍可能逃向无穷。
钟形曲线也没有离开。预算继续增大时,Poisson 的中心波动又进入 Gaussian 尺度;但一条平滑曲线仍看不见格纸上的奇偶与空位。为了计算恰好一个次数的概率,我们必须把反演区间里的每一段频率都照顾到,而不是只看固定频率的极限。
同样是许多独立项相加,有时留下连续的小波动,有时留下稀疏的跳跃,有时连平方根尺度都留不住有限分布。把这些项同时放进逐行改变的实验里,允许大小、尾部和机会一起变化,便会逼出一个更广的问题:究竟哪些结构决定极限的形状,哪些条件保证没有一项独占整个答案?
历史与进一步阅读
Poisson 的原著题名与历史语境,可对照 Oscar Sheynin 的原书英译及说明。本文不把现代 Poisson 概率质量函数、耦合距离与三角数组的整个体系倒写进历史原文;事故纸条与损失账本是本书的现代教学模型,并非未经记录的历史实验。
Le Cam,An approximation theorem for the Poisson binomial distribution,Pacific Journal of Mathematics 10(1960),1181–1197:出版社原刊。本章独立证明所陈述的 d_{\mathrm{TV}}\le\sum p_i^2 界;文献中的测度范数与更强估计不与这里的归一化混同。
现代 Poisson 与局部极限理论可对照 Durrett 的作者公开教材。这里的有限方差格点证明只依赖已经建立的积分、特征函数、实线选择及 \pi–\lambda 工具,未借后面的 Poisson 过程或一般点过程存在定理。
全书广度继续以 Kallenberg 第三版官方书目为参照;本章的模型、论证顺序和叙事围绕本书的计数问题展开。稀有计数的 Poisson 极限不是所有无穷小阵列的分类,有限强度的独立标记也不是一般随机测度理论。