Haobai Wang · 公开阅读版 · ch03-zh-3ce001a8524b
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 3ce001a8524b13a34da67c32bc07592a95d16377aff7f4ed3f78d5aa08773f5b
《偶然的数学》
第一卷 · 偶然可以计算吗?
第三章:钟形曲线的诞生——为什么无数随机现象走向同一种分布?
从 Abraham de Moivre 的二项式近似,到 Laplace 的普遍极限定理,再到 Gauss 的误差理论。
在第二章结束时,我们已经知道一件令人惊讶的事情:
如果 X_1,X_2,\ldots 是独立同分布的 Bernoulli(p) 随机变量,那么
\frac1n\sum_{i=1}^nX_i\xrightarrow{P}p.也就是说,大量重复的随机实验,会呈现出一种越来越稳定的规律。
但如果认真思考,就会发现这只是故事的一半。
大数定律告诉我们随机平均值最终会走向哪里,却没有完整解释它在走向那个极限的过程中如何波动。
假设我们知道一枚硬币是公平的。
抛掷一万次之后,出现五千次正面显然十分正常。
可是,出现五千一百次正面呢?
五千二百次呢?
五千五百次呢?
我们当然可以计算每一种情况的精确概率,但如果重复次数达到一百万、十亿,甚至更大,直接计算组合数将变得极其繁琐。
于是,一个新的数学问题出现:
能否不再逐一计算每个可能结果,而是找到一种能够近似描述整个随机波动形状的数学规律?
这个问题最终引导数学家发现了概率论中最著名的函数之一:
\boxed{
\varphi(x)=\frac1{\sqrt{2\pi}}e^{-x^2/2}.
}
今天,我们称它为标准正态密度。
但我们不准备直接把它定义出来。
我们要弄清楚,为什么数学家会从硬币与组合数的计算中,走向这样一个包含指数函数和圆周率的表达式。
特别是:
一个与圆毫无关系的随机实验,为什么最终会出现 \pi?
3.1 Bernoulli 留下的问题:知道误差会消失,还不够
假设
S_n=X_1+\cdots+X_n,
\qquad
X_i\overset{\mathrm{i.i.d.}}{\sim}\operatorname{Bernoulli}(1/2).
我们知道
S_n\sim\operatorname{Binomial}(n,1/2).因此
P(S_n=k)=\binom nk2^{-n}.对于偶数 n,最可能出现的结果是
k=\frac n2.因为
\frac{P(S_n=k+1)}{P(S_n=k)}
=
\frac{n-k}{k+1}.
当 k 位于中心左侧时,相邻概率倾向于增加;越过中心后则开始减少。
所以二项分布的形状必定表现为:
从左端逐渐增加,到达中间最大,再向右侧下降。
但这只是定性的描述。
我们仍然不知道它究竟以什么速度增加、下降。
先看一个有些反直觉的事实。
当 n 增大时,经验频率
\widehat p_n=\frac{S_n}{n}会越来越接近 1/2。
然而,恰好出现一半正面的概率
P(S_n=n/2)却并不会趋近于1。
事实上,我们将证明它反而趋近于0。
这意味着:
\boxed{
\text{越来越接近中心}
\ne
\text{越来越可能恰好等于中心}.
}
为什么?
因为随着实验次数增加,虽然相对误差变小,但成功次数的绝对波动却在增加。
我们已经知道
\operatorname{Var}(S_n)=\frac n4,所以
\operatorname{SD}(S_n)=\frac{\sqrt n}{2}.成功次数的典型波动尺度,不是一个固定常数,而是 \sqrt n。
因此,当抛掷次数变大时,概率质量实际上会分散到中心附近越来越多的整数上。
单个整数的概率可能越来越小,但落在一个适当扩大的中心区域中的总概率却能够保持很高。
这正是我们接下来要研究的结构。
3.2 Abraham de Moivre:如何计算一个几乎无法计算的二项式?
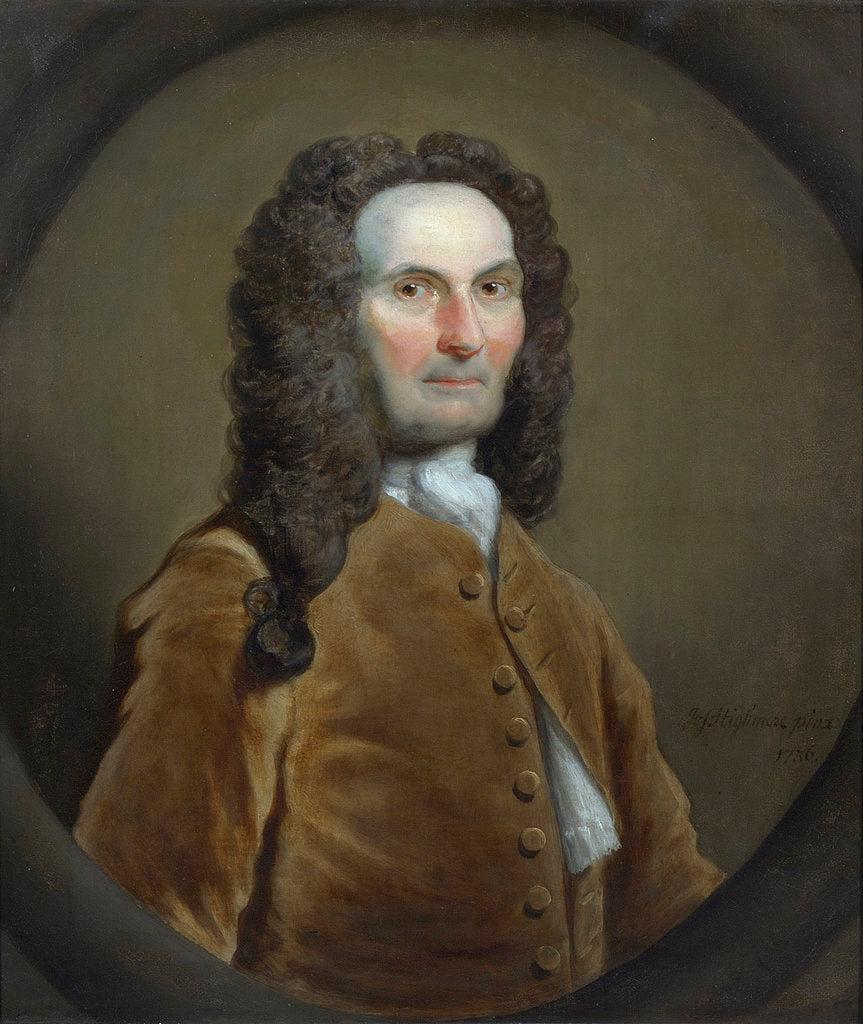
Abraham de Moivre(1667—1754)
法国出生、后来长期生活在英国的数学家。除概率问题外,还研究三角分析与年金数学。
1733年,他写出关于高次二项式项之和的拉丁文论文 Approximatio ad Summam Terminorum Binomii。其英文版本于1738年收入第二版 The Doctrine of Chances。
de Moivre 所面对的问题十分具体。
在高次二项式展开中,我们可以精确写出每一项:
(a+b)^n
=
\sum_{k=0}^n\binom nk a^kb^{n-k}.
但如果 n 很大,想要计算许多相邻项的和,将变得非常困难。
而概率问题恰好经常要求这样的求和。
例如,当 p=1/2 时,
P(a\le S_n\le b)
=
2^{-n}\sum_{k=a}^b\binom nk.
de Moivre 在1733年的工作中,研究了如何通过一种连续的数学表达式来近似这些组合数的求和。他的主要早期突破针对对称二项分布,后来 Laplace 将相关思想大幅推广。〔22, 23, 24〕
我们现在沿着他的核心思路,用现代渐近分析重新推导。
3.2.1 先研究最中间的那一项
为了简化表达,令
n=2m.那么
P(S_{2m}=m)
=
\binom{2m}{m}2^{-2m}
=
\frac{(2m)!}{(m!)^2\,4^m}.
直接计算阶乘并不方便。
但我们可以使用 Stirling 公式:
\boxed{
n!\sim\sqrt{2\pi n}\left(\frac ne\right)^n.
}
这里记号
a_n\sim b_n表示
\lim_{n\to\infty}\frac{a_n}{b_n}=1.这个公式本身也有非常值得研究的历史。de Moivre 与 James Stirling 都对阶乘的渐近表达作出重要贡献,而确定正确的常数 \sqrt{2\pi} 是其中的重要一步。〔25〕
现在把它代入中心二项系数。
(2m)!\sim\sqrt{4\pi m}\left(\frac{2m}{e}\right)^{2m},(m!)^2\sim 2\pi m\left(\frac me\right)^{2m}.因此
\begin{aligned}
P(S_{2m}=m)
&=\frac{(2m)!}{(m!)^2\,4^m}\\
&\sim
\frac{
\sqrt{4\pi m}(2m/e)^{2m}
}{
2\pi m(m/e)^{2m}4^m
}\\
&=\frac1{\sqrt{\pi m}}.
\end{aligned}
因为 n=2m,所以也可以写成
\boxed{
P(S_n=n/2)\sim\sqrt{\frac2{\pi n}}.
}
我们终于得到了一个重要结论。
恰好出现一半正面的概率,其数量级是
\frac1{\sqrt n}.所以
P(S_n=n/2)\longrightarrow0.这解释了本章开始提出的那个看似矛盾的现象。
但是,只知道中心一点的概率,还不足以知道整个分布的形状。
我们必须继续研究:
距离中心一定距离的那些项,与中心项相比,究竟有多大?
3.2.2 从中心向外移动
仍然令 n=2m。
定义
p_m(j)=P(S_{2m}=m+j).由于对称性,
p_m(j)=p_m(-j).所以只需考虑 j\ge0。
由二项系数之间的关系,
\frac{p_m(j)}{p_m(0)}
=
\frac{\binom{2m}{m+j}}{\binom{2m}{m}}.
化简得到
\frac{p_m(j)}{p_m(0)}
=
\frac{m!\,m!}{(m+j)!(m-j)!}.
进一步展开为乘积:
\boxed{
\frac{p_m(j)}{p_m(0)}
=
\prod_{r=1}^j\frac{m-r+1}{m+r}.
}
这个表达式很有意思。
我们已经把一个巨大的组合数之比,转化成了一系列接近1的因子的乘积。
那么如何分析很多接近1的数相乘?
自然的选择是取对数。
因为对数将乘积转化为求和:
\log\frac{p_m(j)}{p_m(0)}
=
\sum_{r=1}^j
\log\left(\frac{m-r+1}{m+r}\right).
将每项写成
\log\left(1-\frac{r-1}{m}\right)
-
\log\left(1+\frac rm\right).
现在使用 Taylor 展开:
\log(1+x)=x-\frac{x^2}{2}+O(x^3),当 x 接近0时成立。
只要 j 不相对于 m 增长得太快,就可以控制所有这些展开项。
对于 j=O(\sqrt m),累加后的主要项为
\begin{aligned}
\log\frac{p_m(j)}{p_m(0)}
&=
-\frac1m\sum_{r=1}^j(2r-1)+o(1)\\
&=-\frac{j^2}{m}+o(1).
\end{aligned}
这里我们利用
\sum_{r=1}^j(2r-1)=j^2.于是
\frac{p_m(j)}{p_m(0)}
\sim e^{-j^2/m}.
结合中心项的近似
p_m(0)\sim\frac1{\sqrt{\pi m}},终于得到
\boxed{
P(S_{2m}=m+j)
\sim
\frac1{\sqrt{\pi m}}e^{-j^2/m}
}
其中 j=O(\sqrt m);更严格地说,在 |j|\le C\sqrt m 的任意固定中心窗口内,相应的近似误差可以一致地控制。
这里,一个全新的函数形式突然出现:
e^{-j^2/m}.我们没有假设正态分布。
我们甚至没有提及什么是连续概率密度。
指数中的平方项,是从二项系数的结构与对数的 Taylor 展开中自然产生的。
这就是钟形曲线的数学来源。
3.3 为什么必须使用 \sqrt n 进行标准化?
刚才我们推导出
P(S_{2m}=m+j)
\approx
\frac1{\sqrt{\pi m}}e^{-j^2/m}.
这里出现了一个重要问题。
如果我们让 m\to\infty,同时固定 j,那么
\frac{j^2}{m}\to0.于是
e^{-j^2/m}\to1.这意味着,在 j 固定的情况下,中心附近不同位置的概率渐渐变得几乎相等。
这样我们就看不到分布真正的形状了。
因此,我们必须寻找一种正确的观察尺度。
观察指数
\frac{j^2}{m}.如果希望当 m\to\infty 时,它仍然保留非平凡的变化,那么应该让
j\asymp\sqrt m.这就是平方根尺度自然出现的原因。
不是因为我们事先知道标准差的定义,也不是因为我们想强行得到正态分布。
而是因为只有在这个尺度下,二项分布中心附近的相对概率才会产生非平凡的极限形状。
现在定义
Z_n=\frac{S_n-n/2}{\sqrt n/2}.它正是将成功次数减去期望,再除以标准差。
当 n=2m,且 S_n=m+j 时,
Z_n=\frac{2j}{\sqrt n}.令
z=\frac{2j}{\sqrt n}.则
\frac{j^2}{m}=\frac{z^2}{2}.所以先前的近似变成
P\left(Z_n=z\right)
\approx
\sqrt{\frac2{\pi n}}e^{-z^2/2},
其中 z 必须是 Z_n 实际可取的格点值。
而相邻格点之间的距离是
\Delta z=\frac2{\sqrt n}.因此
\begin{aligned}
P(Z_n=z)
&\approx
\frac2{\sqrt n}\cdot
\frac1{\sqrt{2\pi}}e^{-z^2/2}\\
&=\Delta z\,\varphi(z).
\end{aligned}
这里
\boxed{
\varphi(z)=\frac1{\sqrt{2\pi}}e^{-z^2/2}.
}
现在,事情变得格外清楚。
原本的二项分布是一系列离散的概率质量。
但随着 n\to\infty,标准化后的相邻取值间隔越来越小。
每个取值对应的概率质量则近似等于
\text{间隔宽度}\times\text{某个连续函数的高度}.我们得到的,就是那个连续函数:
\varphi(z).这就是钟形曲线从离散概率中诞生的数学过程。
3.3.1 亲眼观察钟形曲线的出现
下面把不同 n 下的二项概率质量除以格点宽度,再与标准正态密度比较。
公平硬币;将标准化后的单点概率除以格点间距,形成可比较的曲线高度。
查看母稿数值表
| z | n = 16 | n = 64 | 标准正态密度 |
|---|---|---|---|
| -3 | 0.00366 | 0.00425 | 0.00443 |
| -2.5 | 0.01709 | 0.01742 | 0.01753 |
| -2 | 0.05554 | 0.05435 | 0.05399 |
| -1.5 | 0.1333 | 0.13044 | 0.12952 |
| -1 | 0.24438 | 0.24259 | 0.24197 |
| -0.5 | 0.34912 | 0.35134 | 0.35207 |
| 0 | 0.39276 | 0.39739 | 0.39894 |
| 0.5 | 0.34912 | 0.35134 | 0.35207 |
| 1 | 0.24438 | 0.24259 | 0.24197 |
| 1.5 | 0.1333 | 0.13044 | 0.12952 |
| 2 | 0.05554 | 0.05435 | 0.05399 |
| 2.5 | 0.01709 | 0.01742 | 0.01753 |
| 3 | 0.00366 | 0.00425 | 0.00443 |
图中用线连接离散格点仅为视觉比较,并不意味着二项分布本身已经具有连续密度。
随着 n 增加,经过正确标准化的离散概率质量越来越接近同一个连续函数。
这里还有一件值得注意的事。
我们并没有改变硬币本身。
每一次抛掷仍然只有正面与反面。
连续的钟形曲线,并不是单次随机实验本身具有的形状,而是大量离散随机结果经过求和与重新缩放后出现的极限结构。
3.4 从组合数的求和,到积分的出现
我们现在有了局部近似:
P(Z_n=z_{n,k})
\approx
\Delta z_n\,\varphi(z_{n,k}),
其中
z_{n,k}=\frac{k-n/2}{\sqrt n/2},
\qquad
\Delta z_n=\frac2{\sqrt n}.
但是,de Moivre 原本想解决的问题,并不只是近似一个二项系数。
他真正关心的是许多项的和。
考虑任意固定实数 a<b。
我们希望计算
P(a\le Z_n\le b).按照定义,
P(a\le Z_n\le b)
=
\sum_{\substack{k:\\a\le z_{n,k}\le b}}
P(Z_n=z_{n,k}).
利用刚才得到的近似,
P(a\le Z_n\le b)
\approx
\sum_{\substack{k:\\a\le z_{n,k}\le b}}
\varphi(z_{n,k})\Delta z_n.
现在仔细看右边。
它是不是非常熟悉?
这正是一个 Riemann 和。
当 n\to\infty 时,
\Delta z_n=\frac2{\sqrt n}\to0.因此,我们应当得到
\boxed{
\lim_{n\to\infty}P(a\le Z_n\le b)
=
\int_a^b
\frac1{\sqrt{2\pi}}e^{-z^2/2}\,dz.
}
这就是 de Moivre–Laplace 极限定理在对称 Bernoulli 情况下的形式。
这里有必要说明严格性。
我们不能仅仅知道每个固定位置附近存在近似,就直接交换无限求和与极限。
真正需要的是,在固定的标准化区间 [a,b] 内,局部概率近似的相对误差能够一致地趋于零。
前面在 |j|\le C\sqrt n 范围内得到的渐近展开,正好提供了这种控制。
因此,极限才可以由 Riemann 和严格推出。
3.4.1 为什么正态密度的积分等于1?
至此,我们还没有解释
\frac1{\sqrt{2\pi}}究竟为什么是正确的归一化常数。
要使 \varphi 成为概率密度,必须满足
\int_{-\infty}^{\infty}\varphi(x)\,dx=1.因此需要计算
I=\int_{-\infty}^{\infty}e^{-x^2/2}\,dx.这个积分无法用初等函数写出原函数,但定积分却可以精确计算。
考虑
I^2
=
\int_{\mathbb R^2}
e^{-(x^2+y^2)/2}\,dx\,dy.
我们从一维转到了二维。
改用极坐标:
x=r\cos\theta,
\qquad
y=r\sin\theta.
Jacobian 为 r,所以
\begin{aligned}
I^2
&=
\int_0^{2\pi}\int_0^\infty
e^{-r^2/2}r\,dr\,d\theta\\
&=2\pi\left[-e^{-r^2/2}\right]_0^\infty\\
&=2\pi.
\end{aligned}
因此
I=\sqrt{2\pi}.于是
\boxed{
\int_{-\infty}^{\infty}
\frac1{\sqrt{2\pi}}e^{-x^2/2}\,dx=1.
}
我们终于可以回答本章开始的一个问题:
为什么硬币的极限分布会出现 \pi?
因为二项系数在中心附近的渐近结构产生了二次指数函数,而这个函数的归一化与二维欧氏空间中的圆对称性密切相关。
圆周率并不是硬币的物理性质。
它是我们最终遇到的连续数学结构的几何常数。
这是概率论中非常美妙的一种统一:
有限组合数学,通过极限走向微积分;而积分中的几何对称性,又决定了概率分布的归一化常数。
3.5 Laplace:为什么钟形曲线不应该只属于硬币?
到了这里,我们已经理解了一个特殊结论:
\frac{S_n-n/2}{\sqrt n/2}
\xrightarrow{d}N(0,1).
其中 N(0,1) 表示标准正态分布,符号 \xrightarrow d 表示依分布收敛。
但是,一个更加令人激动的问题随之出现:
为什么我们只能研究正面和反面?
假设现在不是抛硬币,而是掷骰子。
或者每天观察温度误差。
或者研究许多不同的小扰动叠加产生的总误差。
这些单独的随机变量,其分布可能完全不是对称二项分布。
那么,它们的和经过标准化后,是否仍然会走向同一个钟形曲线?
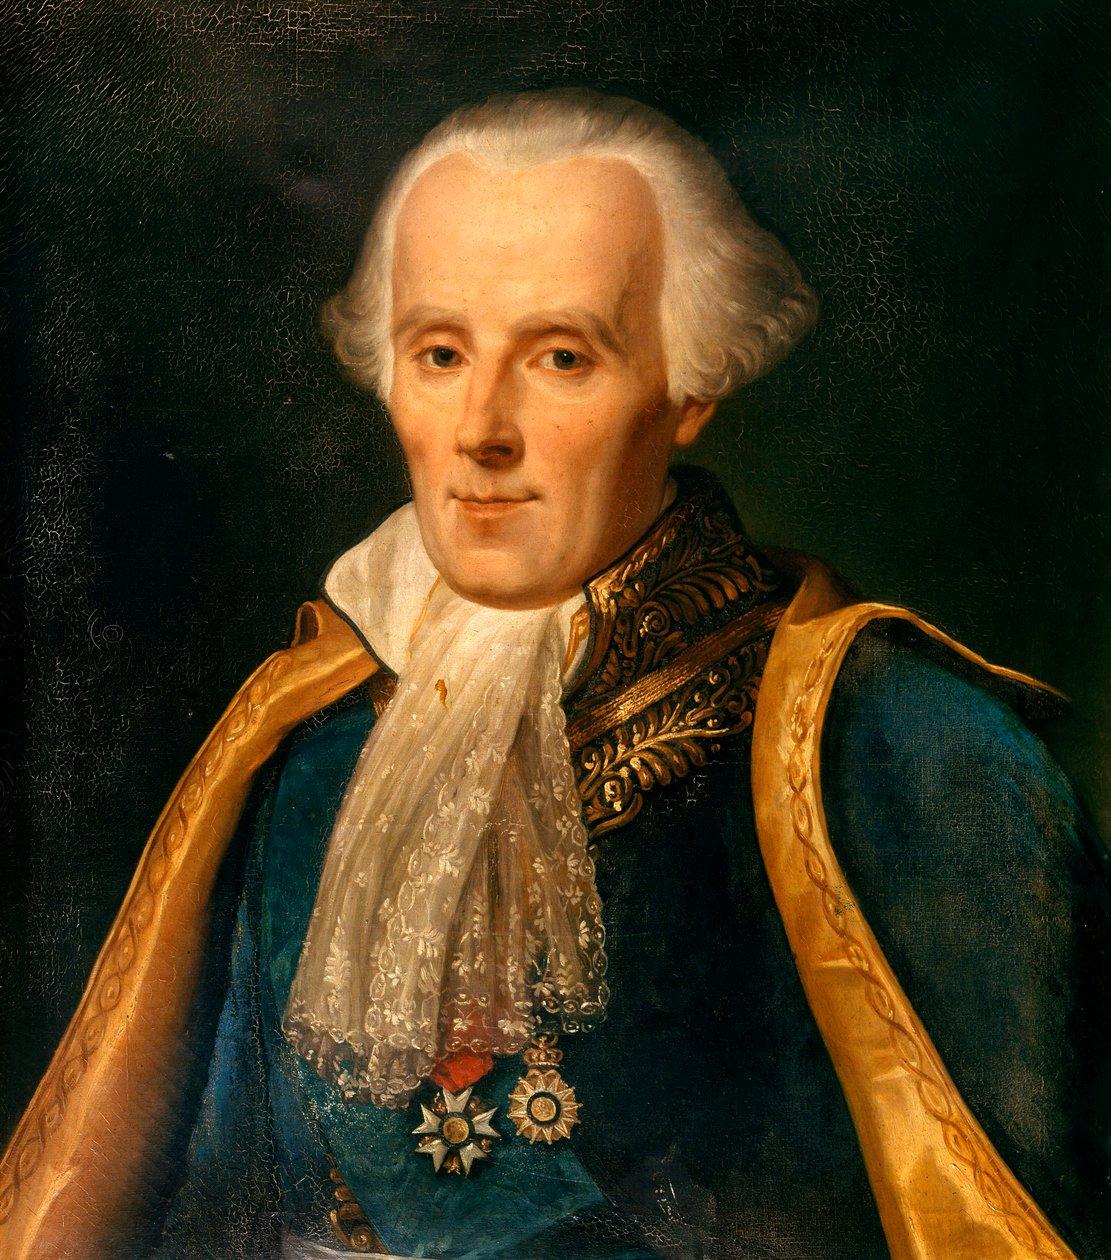
Pierre-Simon Laplace(1749—1827)
法国数学家、天文学家。
Laplace 将概率计算推进到更加一般的解析理论中。尤其在1810年前后的工作及1812年出版的 Théorie analytique des probabilités 中,研究了远比对称二项分布更普遍的随机和的近似。
从 de Moivre 的特殊近似到一般中心极限定理,并不是一次简单的符号替换,而经历了相当长的数学发展。Laplace 的相关工作是这一历史进程的关键节点。〔26, 27, 28〕
我们现在使用现代数学语言研究这一推广。
设
X_1,X_2,\ldots为独立同分布随机变量,并假设
\mathbb E[X_i]=\mu,0<\operatorname{Var}(X_i)=\sigma^2<\infty.它们可以是离散的,也可以是连续的。
分布可以对称,也可以偏斜。
我们不假设它们具有钟形密度。
现在定义
S_n=X_1+\cdots+X_n.由于期望的线性性,
\mathbb E[S_n]=n\mu.由于独立性,
\operatorname{Var}(S_n)=n\sigma^2.因此,最自然的标准化方式是
Z_n=\frac{S_n-n\mu}{\sigma\sqrt n}.这里出现了与硬币问题完全相同的 \sqrt n。
这已经暗示某种更普遍的结构。
在这些条件下,现代 Lindeberg–Lévy 中心极限定理告诉我们:
\boxed{
\frac{S_n-n\mu}{\sigma\sqrt n}
\xrightarrow{d}N(0,1).
}
请认真体会这个结论。
左侧的每一个 X_i,可以具有大量不同的分布形状。
但它们经过独立求和、中心化和标准化之后,其极限分布却是同一个 N(0,1)。
这是概率论真正意义上的普遍性现象。
从某种意义上说,大量随机因素的累加,会使最终的分布失去许多关于单独因素的细节。
在有限方差的独立同分布模型中,极限所需要保留的尺度信息主要由均值和方差决定。
为什么如此?
我们还必须解释其中的机制。
3.6 中心极限定理的真正秘密:为什么分布的细节会消失?
校订补注:特征函数二阶展开的余项控制见附录 D;这里不额外假设三阶矩。
我们已经知道如何从二项式展开推导正态分布。
但如果 X_i 具有完全不同的分布,组合数方法就不再适用了。
我们需要一种全新的数学语言。
这个问题将引导我们进入概率论与 Fourier 分析的深刻联系。
3.6.1 为什么要研究复指数?
假设随机变量 X 的分布可能非常复杂。
直接研究其独立和
S_n=X_1+\cdots+X_n的分布,通常需要不断计算卷积。
例如,若 X,Y 独立并具有密度 f_X,f_Y,则
f_{X+Y}(z)
=
\int_{\mathbb R}f_X(x)f_Y(z-x)\,dx.
如果有 n 个随机变量,就会出现反复卷积。
这是相当复杂的运算。
但是,数学家早已在其他问题中发现:某些函数变换能够将复杂的运算转化成简单的代数操作。
现在定义随机变量 X 的特征函数(characteristic function):
\boxed{
\phi_X(t)=\mathbb E[e^{itX}],
\qquad t\in\mathbb R.
}
这个定义看起来有些突兀。
为什么要引入虚数单位 i?
为什么偏偏使用指数函数?
因为指数函数具有一个非常有用的性质:
e^{it(x+y)}=e^{itx}e^{ity}.因此,如果 X,Y 独立,
\begin{aligned}
\phi_{X+Y}(t)
&=\mathbb E[e^{it(X+Y)}]\\
&=\mathbb E[e^{itX}e^{itY}]\\
&=\mathbb E[e^{itX}]\mathbb E[e^{itY}]\\
&=\phi_X(t)\phi_Y(t).
\end{aligned}
于是
\boxed{
\phi_{X+Y}(t)=\phi_X(t)\phi_Y(t).
}
我们成功地把随机变量的加法,转化成了特征函数的乘法。
这与本章前面利用对数把乘积转化成求和具有相似的思想:
面对复杂的运算,寻找一种表示方式,使原本困难的结构变成简单的代数关系。
后续理论依赖:以下是对历史结果的现代语言重建,不是 de Moivre 或 Laplace 当年的证明。二阶展开的余项控制见附录 D;复数随机变量的积分语言在第6章建立,特征函数唯一性与 Lévy 连续性定理在第11章系统证明,第7章先区分相应收敛概念。本节沿乘积与二阶项的故事继续推导,不把这些外部调用冒充已在本章证明的结论。
3.6.2 用特征函数重新证明中心极限定理
令
Y_i=\frac{X_i-\mu}{\sigma}.那么
\mathbb E[Y_i]=0,
\qquad
\mathbb E[Y_i^2]=1.
标准化随机和可以写成
Z_n=\frac1{\sqrt n}\sum_{i=1}^nY_i.现在我们研究 Y_i 的特征函数在 t=0 附近的行为。
利用
e^{ity}=1+ity-\frac{t^2y^2}{2}+\cdots,我们期待
\phi_Y(t)
=
1+it\mathbb E[Y]
-\frac{t^2}{2}\mathbb E[Y^2]
+o(t^2).
由于均值为0、方差为1,
\boxed{
\phi_Y(t)=1-\frac{t^2}{2}+o(t^2).
}
这里并不需要假设 Y 具有三阶矩。
只要二阶矩有限,上述展开就可以成立。严格证明可利用
\frac{e^{iu}-1-iu}{u^2}\longrightarrow-\frac12以及相应的有界性,通过控制期望来得到二阶展开。
现在,由于 Y_1,\ldots,Y_n 独立,
\begin{aligned}
\phi_{Z_n}(t)
&=
\prod_{i=1}^n
\phi_{Y_i}\left(\frac{t}{\sqrt n}\right)\\
&=
\left[
\phi_Y\left(\frac{t}{\sqrt n}\right)
\right]^n.
\end{aligned}
利用刚才的 Taylor 展开,
\phi_Y\left(\frac{t}{\sqrt n}\right)
=
1-\frac{t^2}{2n}+o\left(\frac1n\right).
因此
\phi_{Z_n}(t)
=
\left[
1-\frac{t^2}{2n}+o\left(\frac1n\right)
\right]^n.
回忆一个基本极限:
\left(1+\frac an+o\left(\frac1n\right)\right)^n
\longrightarrow e^a.
于是
\boxed{
\lim_{n\to\infty}\phi_{Z_n}(t)
=
e^{-t^2/2}.
}
而
e^{-t^2/2}恰好就是标准正态随机变量的特征函数。
根据特征函数的连续性定理,我们便得到
\boxed{Z_n\xrightarrow d N(0,1).}证毕。
这个现代证明与 de Moivre、Laplace 当年的原始推导并不相同,但它让我们看到了中心极限定理最本质的数学机制。
3.6.3 为什么最后只剩下二阶项?
重新看一遍:
\phi_Y(t)=1-\frac{t^2}{2}+o(t^2).在标准化求和时,我们把 t 替换为 t/\sqrt n。
于是二阶项成为
\frac{t^2}{n}.将 n 个独立随机变量的特征函数相乘,就会产生一个非平凡的极限:
n\cdot\frac{t^2}{n}=t^2.更高阶的项则在适当矩条件下逐渐消失。
例如,若三阶矩存在,三阶项的累计数量级为
n\left(\frac t{\sqrt n}\right)^3
=
\frac{t^3}{\sqrt n}
\to0.
四阶项对应
n\left(\frac t{\sqrt n}\right)^4
=
\frac{t^4}{n}
\to0.
因此,极限中只保留了二阶结构。
这解释了为什么大量不同分布经过独立求和后,会出现相同的极限。
我们不需要知道每个分布的全部细节。
在这个极限尺度下,许多更高阶的细节会变得不可见。
而二阶项带来的特征函数
e^{-t^2/2}恰好对应正态分布。
所以,中心极限定理绝非偶然地宣称很多随机变量的和“看起来像钟形”。
它反映的是:
独立求和与平方根标准化这一运算,在极限中保留二阶结构、弱化其他局部细节的数学规律。
这是正态分布普遍性的一个核心原因。
3.7 Gauss:为什么天文学家也会遇到钟形曲线?
到目前为止,我们沿着赌博、二项式以及独立随机和的道路,发现了正态分布。
然而,历史上还有另一条重要的道路,最终走向了同一个函数。
这条道路并不是从骰子出发。
而是从天文学的测量误差出发。
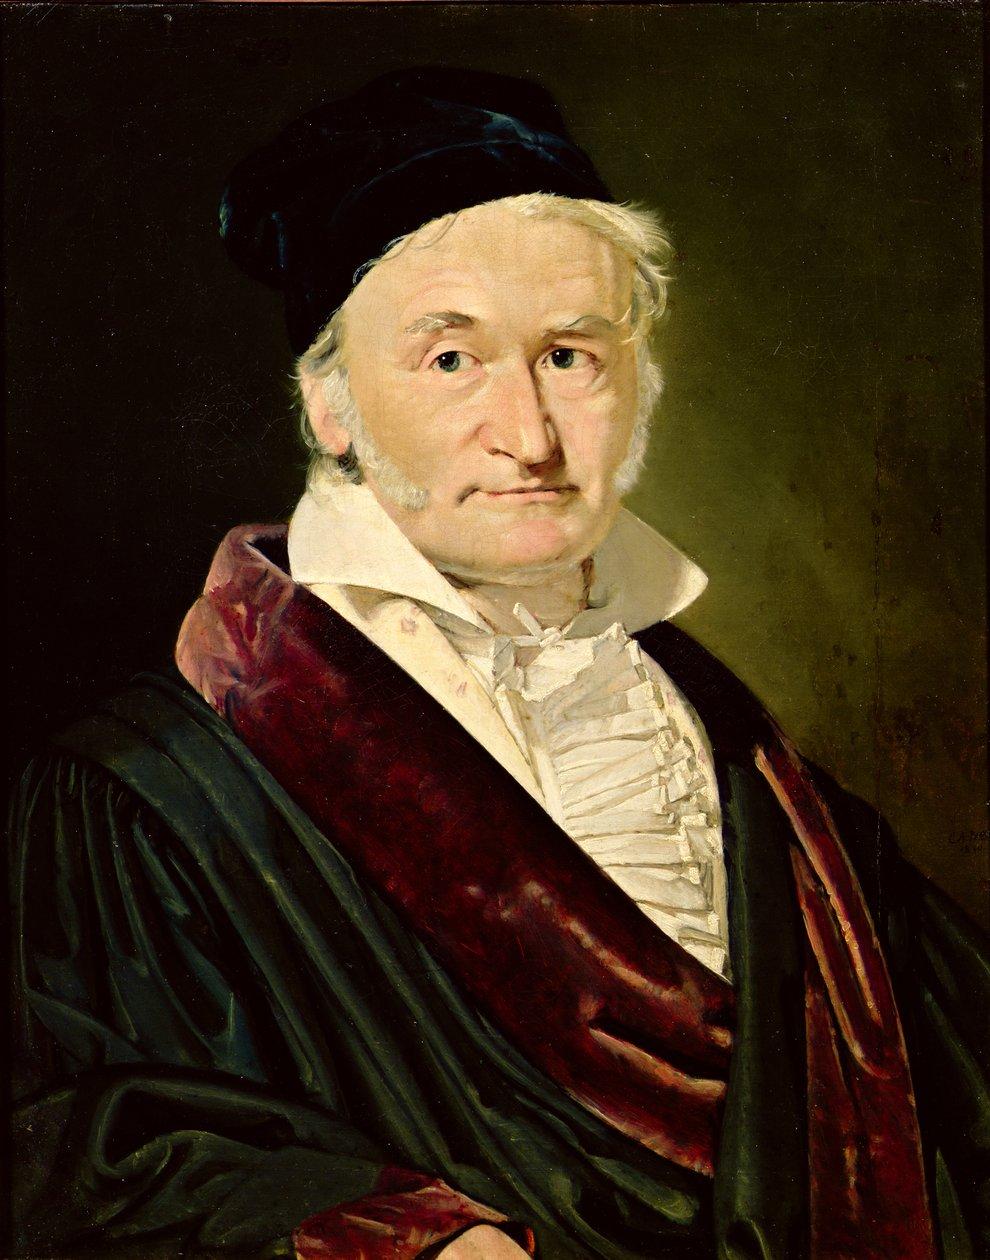
Carl Friedrich Gauss(1777—1855)
德国数学家、天文学家。
1809年,他在 Theoria Motus Corporum Coelestium 中讨论天体轨道与观测误差,并给出了正态误差分布与最小二乘估计之间的重要联系。
在此之前,Legendre 已于1805年发表最小二乘方法;Robert Adrain 也在1808年独立研究了正态误差规律。因此,把正态分布简单称为 Gauss 一个人的发现,并不符合实际数学史。〔27, 29, 30〕
但 Gauss 的论证中,有一个极其值得深入研究的思想:
为什么当我们反复测量同一个未知数量时,会倾向于使用算术平均值作为估计?
例如,我们测量一个未知长度 \theta,得到
Y_1,\ldots,Y_n.假设
Y_i=\theta+\varepsilon_i,其中 \varepsilon_i 是测量误差。
数学家希望从这些有误差的观察中恢复 \theta。
一个自然的方法是取平均:
\widehat\theta=\frac1n\sum_{i=1}^nY_i.但是,为什么平均值应该是正确的估计?
我们能不能反过来问:
如果我们要求算术平均值是最可能的估计,那么误差的概率分布必须长成什么样?
阅读路线:这里回到 Gauss 的误差与估计问题,是 Gaussian 规律的另一条历史来源,不是说 Gauss 在现代特征函数证明之后工作。下文的函数方程推导是现代重建;可测加性函数的线性结论仍作为待补工具,相关正则性问题保留在审校问题册。
3.7.1 从最佳估计反推出概率分布
假设误差 \varepsilon_i 独立同分布,并具有处处正且可微的密度 f。
那么观察到 y_1,\ldots,y_n 时,参数 \theta 对应的似然函数是
L(\theta)=\prod_{i=1}^n f(y_i-\theta).现在提出一个强假设:
无论样本是什么、样本量是多少,算术平均值
\overline y=\frac1n\sum_{i=1}^ny_i都应该是一个最大似然估计值。
我们看看这个要求对密度 f 施加什么约束。
为了方便计算,令
\psi(x)=\frac{f'(x)}{f(x)}.对对数似然求导:
\frac{d}{d\theta}\log L(\theta)
=
-\sum_{i=1}^n\psi(y_i-\theta).
如果最大值出现在 \theta=\overline y,那么一阶条件要求
\sum_{i=1}^n\psi(y_i-\overline y)=0.令
r_i=y_i-\overline y.注意
\sum_{i=1}^nr_i=0.因此我们的假设意味着:
对任何满足 \sum r_i=0 的残差组,都有
\boxed{\sum_{i=1}^n\psi(r_i)=0.}先考虑 n=2。
取残差为 x,-x,则
\psi(x)+\psi(-x)=0.所以 \psi 是奇函数。
再考虑 n=3。
取残差为
x,\quad y,\quad -(x+y).于是
\psi(x)+\psi(y)+\psi(-(x+y))=0.利用奇函数性质,
\boxed{
\psi(x+y)=\psi(x)+\psi(y).
}
这就是 Cauchy 函数方程!
如果我们加入连续性等适当正则性条件,那么
\psi(x)=cx对于某个常数 c 成立。
但因为
\psi(x)=\frac{f'(x)}{f(x)},所以
\frac{d}{dx}\log f(x)=cx.积分得到
\log f(x)=\frac c2x^2+C.于是
f(x)=Ae^{cx^2/2}.为了使 f 成为整个实数轴上的可积概率密度,必须有
c<0.令
c=-\frac1{\sigma^2},则
f(x)=Ae^{-x^2/(2\sigma^2)}.归一化后得到
\boxed{
f(x)=
\frac1{\sqrt{2\pi}\sigma}
e^{-x^2/(2\sigma^2)}.
}
我们又一次得到了正态密度!
但这次它不是来自二项系数的极限。
而是来自一个关于估计方法的要求:
若在上述独立同分布的误差模型和正则条件下,要求算术平均值对于所有样本都成为最大似然估计,就会导出正态误差分布。
这是对 Gauss 1809年论证思路的一种现代化重建。它并不证明现实世界中的一切观测误差都服从正态分布;它说明平均值的某种最优性要求与正态模型之间存在特殊联系。〔30〕
从这里进一步出发,我们便能理解为什么最小二乘法与正态分布紧密相连。
因为正态误差模型中的负对数似然,除了与 \theta 无关的常数及正比例因子之外,恰好是
\sum_{i=1}^n(y_i-\theta)^2.最大化似然,就是最小化平方误差。
因此
\boxed{
\text{正态误差模型}
\Longrightarrow
\text{最小二乘与最大似然相联系}.
}
历史上由不同问题出发的数学方法,在这里获得了统一的解释。
3.8 难道所有随机现象最终都会变成正态分布?
讲到这里,正态分布似乎变得无所不能。
硬币的总和走向正态分布。
一般独立随机变量的标准化总和也走向正态分布。
测量误差的分析又一次出现正态密度。
我们是否可以因此认为,正态分布是随机现象不可避免的最终形态?
答案是否定的。
中心极限定理具有十分明确的假设。
如果这些假设被破坏,结论就可能完全不同。
我们来看一个尤其重要的例子。
后续理论依赖:本例的特征函数公式与由特征函数识别分布,仍按已知结果使用,计算及唯一性理论安排在第11章;不因这里展示一个反例就宣称相应理论已经建立。
3.8.1 Cauchy 分布:一个不会被平均驯服的随机变量
设
X_1,X_2,\ldots独立同分布,并且每个随机变量都具有标准 Cauchy 分布:
f(x)=\frac1{\pi(1+x^2)}.它的特征函数为
\phi_X(t)=e^{-|t|}.现在计算样本平均值
\overline X_n=\frac1n\sum_{i=1}^nX_i.利用特征函数和独立性,
\begin{aligned}
\phi_{\overline X_n}(t)
&=
\prod_{i=1}^n
\phi_X\left(\frac tn\right)\\
&=
\left(e^{-|t|/n}\right)^n\\
&=e^{-|t|}.
\end{aligned}
这竟然与单个 X_i 的特征函数完全相同。
因此
\boxed{
\overline X_n\overset d=X_1
}
对于任何 n\ge1 都成立。
这意味着:
无论我们平均多少个独立的标准 Cauchy 随机变量,所得平均值的分布都不会变得更加集中。
它依然是标准 Cauchy 分布。
这里大数定律中常见的收敛结论不成立,标准的有限方差中心极限定理当然也无法应用。
原因在于 Cauchy 分布没有有限的一阶绝对矩,也没有有限方差。
现在,我们终于发现:
正态分布的普遍性不是无条件的普遍性。
它依赖于随机变量的尾部性质、依赖关系以及求和时所选择的尺度。
一旦这些条件发生改变,极限就可能属于完全不同的分布族。
这将把我们引向后来的稳定分布(stable distributions)、广义中心极限定理,以及现代概率论对重尾现象的研究。
而这恰恰也说明,正态分布不是随机性的终点,而是更广阔的随机极限理论的起点。
第三章结语:我们真正发现了什么?
让我们回顾这一章的整个思想过程。
一开始,我们只有一个非常具体的困难:
计算
2^{-n}\sum_{k=a}^{b}\binom nk在 n 很大时变得异常麻烦。
为了理解它,我们先研究中心项,随后比较相邻的二项系数。
取对数并进行 Taylor 展开以后,出现了
e^{-x^2/2}.为了得到一个非平凡的极限形状,我们不得不引入 \sqrt n 这样的尺度。
随着离散格点间距趋近于零,组合数的求和开始变成积分。
于是,钟形曲线自然出现。
接下来,Laplace 所推动的推广方向告诉我们,这种极限现象并不只属于二项分布。
用现代特征函数的方法,我们进一步看到了其背后的结构:
\left(
1-\frac{t^2}{2n}
+o\left(\frac1n\right)
\right)^n
\longrightarrow e^{-t^2/2}.
一个复杂的随机系统,经过独立求和与适当标准化,在极限中呈现出由二阶结构决定的普遍形态。
另一方面,从 Gauss 对测量误差的分析出发,我们发现正态分布又与算术平均和最小二乘的最优性联系起来。
两条完全不同的问题路径,最终相遇了。
大量随机事件相加 de Moivre → Laplace
\sum X_i测量误差与最佳估计 Legendre → Gauss
\min_\theta\sum(Y_i-\theta)^2正态分布
f(x)=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^2}{2\sigma^2}}概率极限、解析结构与统计估计,在这里发生联系
但我认为,这一章还有一个比所有公式都更加重要的思想。
我们发现了两个原本看起来完全相反的现象:
一方面,随机事件会产生不可预测的波动。
另一方面,这些波动经过足够多次叠加后,又会出现一种稳定而普遍的数学规律。
这不意味着世界不再随机。
恰恰相反。
正是通过认真研究随机性本身,数学家才发现了随机性所允许的秩序。
我们现在能够解释,为什么不同来源的随机误差,可能产生近似相同的钟形曲线。
然而,下一步又出现了一个新的问题。
此前我们研究随机变量时,往往可以先明确写出它们的概率分布。
但现实中的大量随机对象是连续变化的。
例如,一个粒子在液体中不停运动。
我们不只想知道它在某个时刻的位置,还想描述它在整个时间区间内如何随机移动。
更令人困惑的是:
如果我们在越来越短的时间尺度上观察这种运动,最终会看到什么?
当时间间隔趋近于零时,我们是否能够构造一种真正连续、却又始终随机的数学过程?
这将迫使我们从单个随机变量,走向由无限多个随机变量组成的随机过程。
也会使我们再次遭遇一个已经在第一章中初步出现的问题:
当随机结果构成一个无限且复杂的空间时,我们究竟应该怎样定义概率?
这为我们接下来通往测度论、随机过程与 Brownian motion 的道路埋下了伏笔。
下一章预告
第四章:当随机性进入时间——从随机游走到 Brownian motion
我们将从一个最简单的模型开始:
S_n=X_1+\cdots+X_n,
\qquad P(X_i=1)=P(X_i=-1)=\frac12.
然后提出一个问题:
为什么当空间按照 1/\sqrt n 缩小、时间按照 1/n 缩小以后,一个在整数格点上跳跃的随机运动,竟然可能收敛到一个具有连续轨道的随机过程?
那将是我们第一次真正面对随机函数本身,而不仅仅是随机数字。
也将为我们后来研究随机树、CRT 和连续随机几何提供另一条重要的思想基础。
《偶然的数学》· 第一卷第三章 · 工作稿 v0.1