Haobai Wang · 公开阅读版 · ch02-zh-67f96226c5fc
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 67f96226c5fc864eef686e9994db2d039c424444f16e66d240dee6017501596a
《偶然的数学》
第一卷 · 偶然可以计算吗?
第二章:从机会到知识——我们如何认识未知的概率?
从 Jacob Bernoulli 的大数定律,到 Thomas Bayes 的逆向推断。
第一章,我们发现了一件令人惊讶的事情。
一场没有结束的赌博,竟然迫使我们思考什么是公平、什么是机会,以及为什么尚未发生的未来可以成为数学研究的对象。
但我们所建立的理论始终依赖一个特殊条件:
我们事先知道不同结果发生的机会。
对于公平骰子,我们假设六个面等可能。对于公平硬币,我们假设正反面具有相同概率。
那么,如果我们不再知道这些概率,会发生什么?
这一次,我们不能从数学模型直接走向结果。
我们必须从已经观察到的结果出发,反过来认识产生结果的未知规律。
这将引导概率论发生一次根本性的转变。
2.1 一枚不公平的硬币
想象有人交给我们一枚硬币。
我们不知道这枚硬币是否公平,也不知道它有没有被人为加工过。
我们只知道,每次抛掷之后,它会出现正面或反面。
设正面出现的概率是
p.但这次不同于第一章,我们不知道 p 的值。
唯一能够确定的是
0\le p\le1.现在的问题是:
我们能否通过观察硬币的实际表现,知道 p 是多少?
假设我们抛掷十次,结果是七次正面、三次反面。
一个非常自然的回答是:
p\approx\frac7{10}=0.7.但是这个回答究竟有什么数学依据?
如果真实的 p=1/2,十次抛掷完全可能出现七次正面。
如果真实的 p=0.8,也完全可能出现七次正面。
甚至 p=0.3 时,七次正面仍然是一个概率非零的事件。
因此:
\text{观察到七次正面}
\not\implies p=0.7.
我们最多能够说,某些 p 的取值似乎比另外一些更加符合观察。
但“更加符合”又是什么意思?
在回答之前,我们需要先认识一个更根本的区别。
2.2 两种完全不同的不确定性
前面有两个方向相反的问题。
第一个问题:已知概率,预测结果。
假如已知硬币出现正面的概率为 p,我们希望计算未来十次抛掷中出现七次正面的概率。
这属于正向概率问题。
第二个问题:已知结果,推断概率。
假如我们已经观察到十次抛掷中七次正面,希望推断未知的 p。
这属于逆向推断问题。
用现代记号,设
X_i=
\begin{cases}
1,&\text{第 }i\text{ 次为正面},\\
0,&\text{第 }i\text{ 次为反面}.
\end{cases}
在给定 p 时,假设
X_1,\ldots,X_n
\overset{\mathrm{i.i.d.}}{\sim}\operatorname{Bernoulli}(p).
定义
S_n=\sum_{i=1}^n X_i.正向问题研究
P_p(S_n=k).逆向问题则是:
观察到 S_n=k 后,我们能够对 p 作出什么判断?
两者虽然看起来只交换了已知和未知,但数学上存在重大区别。
在第一个问题中,概率模型已经给定。
在第二个问题中,我们试图认识概率模型本身。
正向问题
p\text{ 已知}P_p(S_n=k)从规律到观察
逆向问题
S_n=k\text{ 已知}p\text{ 未知}从观察到规律
在历史上,从赌博数学走向现实世界的推断,正是概率论发展的重要转折之一。
因为在骰子游戏中,我们可以从规则与对称性推导概率。
但对于人的寿命、疾病发生率、自然现象或者社会事件,我们往往没有任何理由事先假定等可能性。
我们所拥有的,只是过去发生过什么。
如果概率论只能处理已知概率的问题,它将永远无法成为研究经验世界的数学。
这正是 Jacob Bernoulli 意识到的重要方向。
2.3 Jacob Bernoulli:我们能否通过经验发现概率?
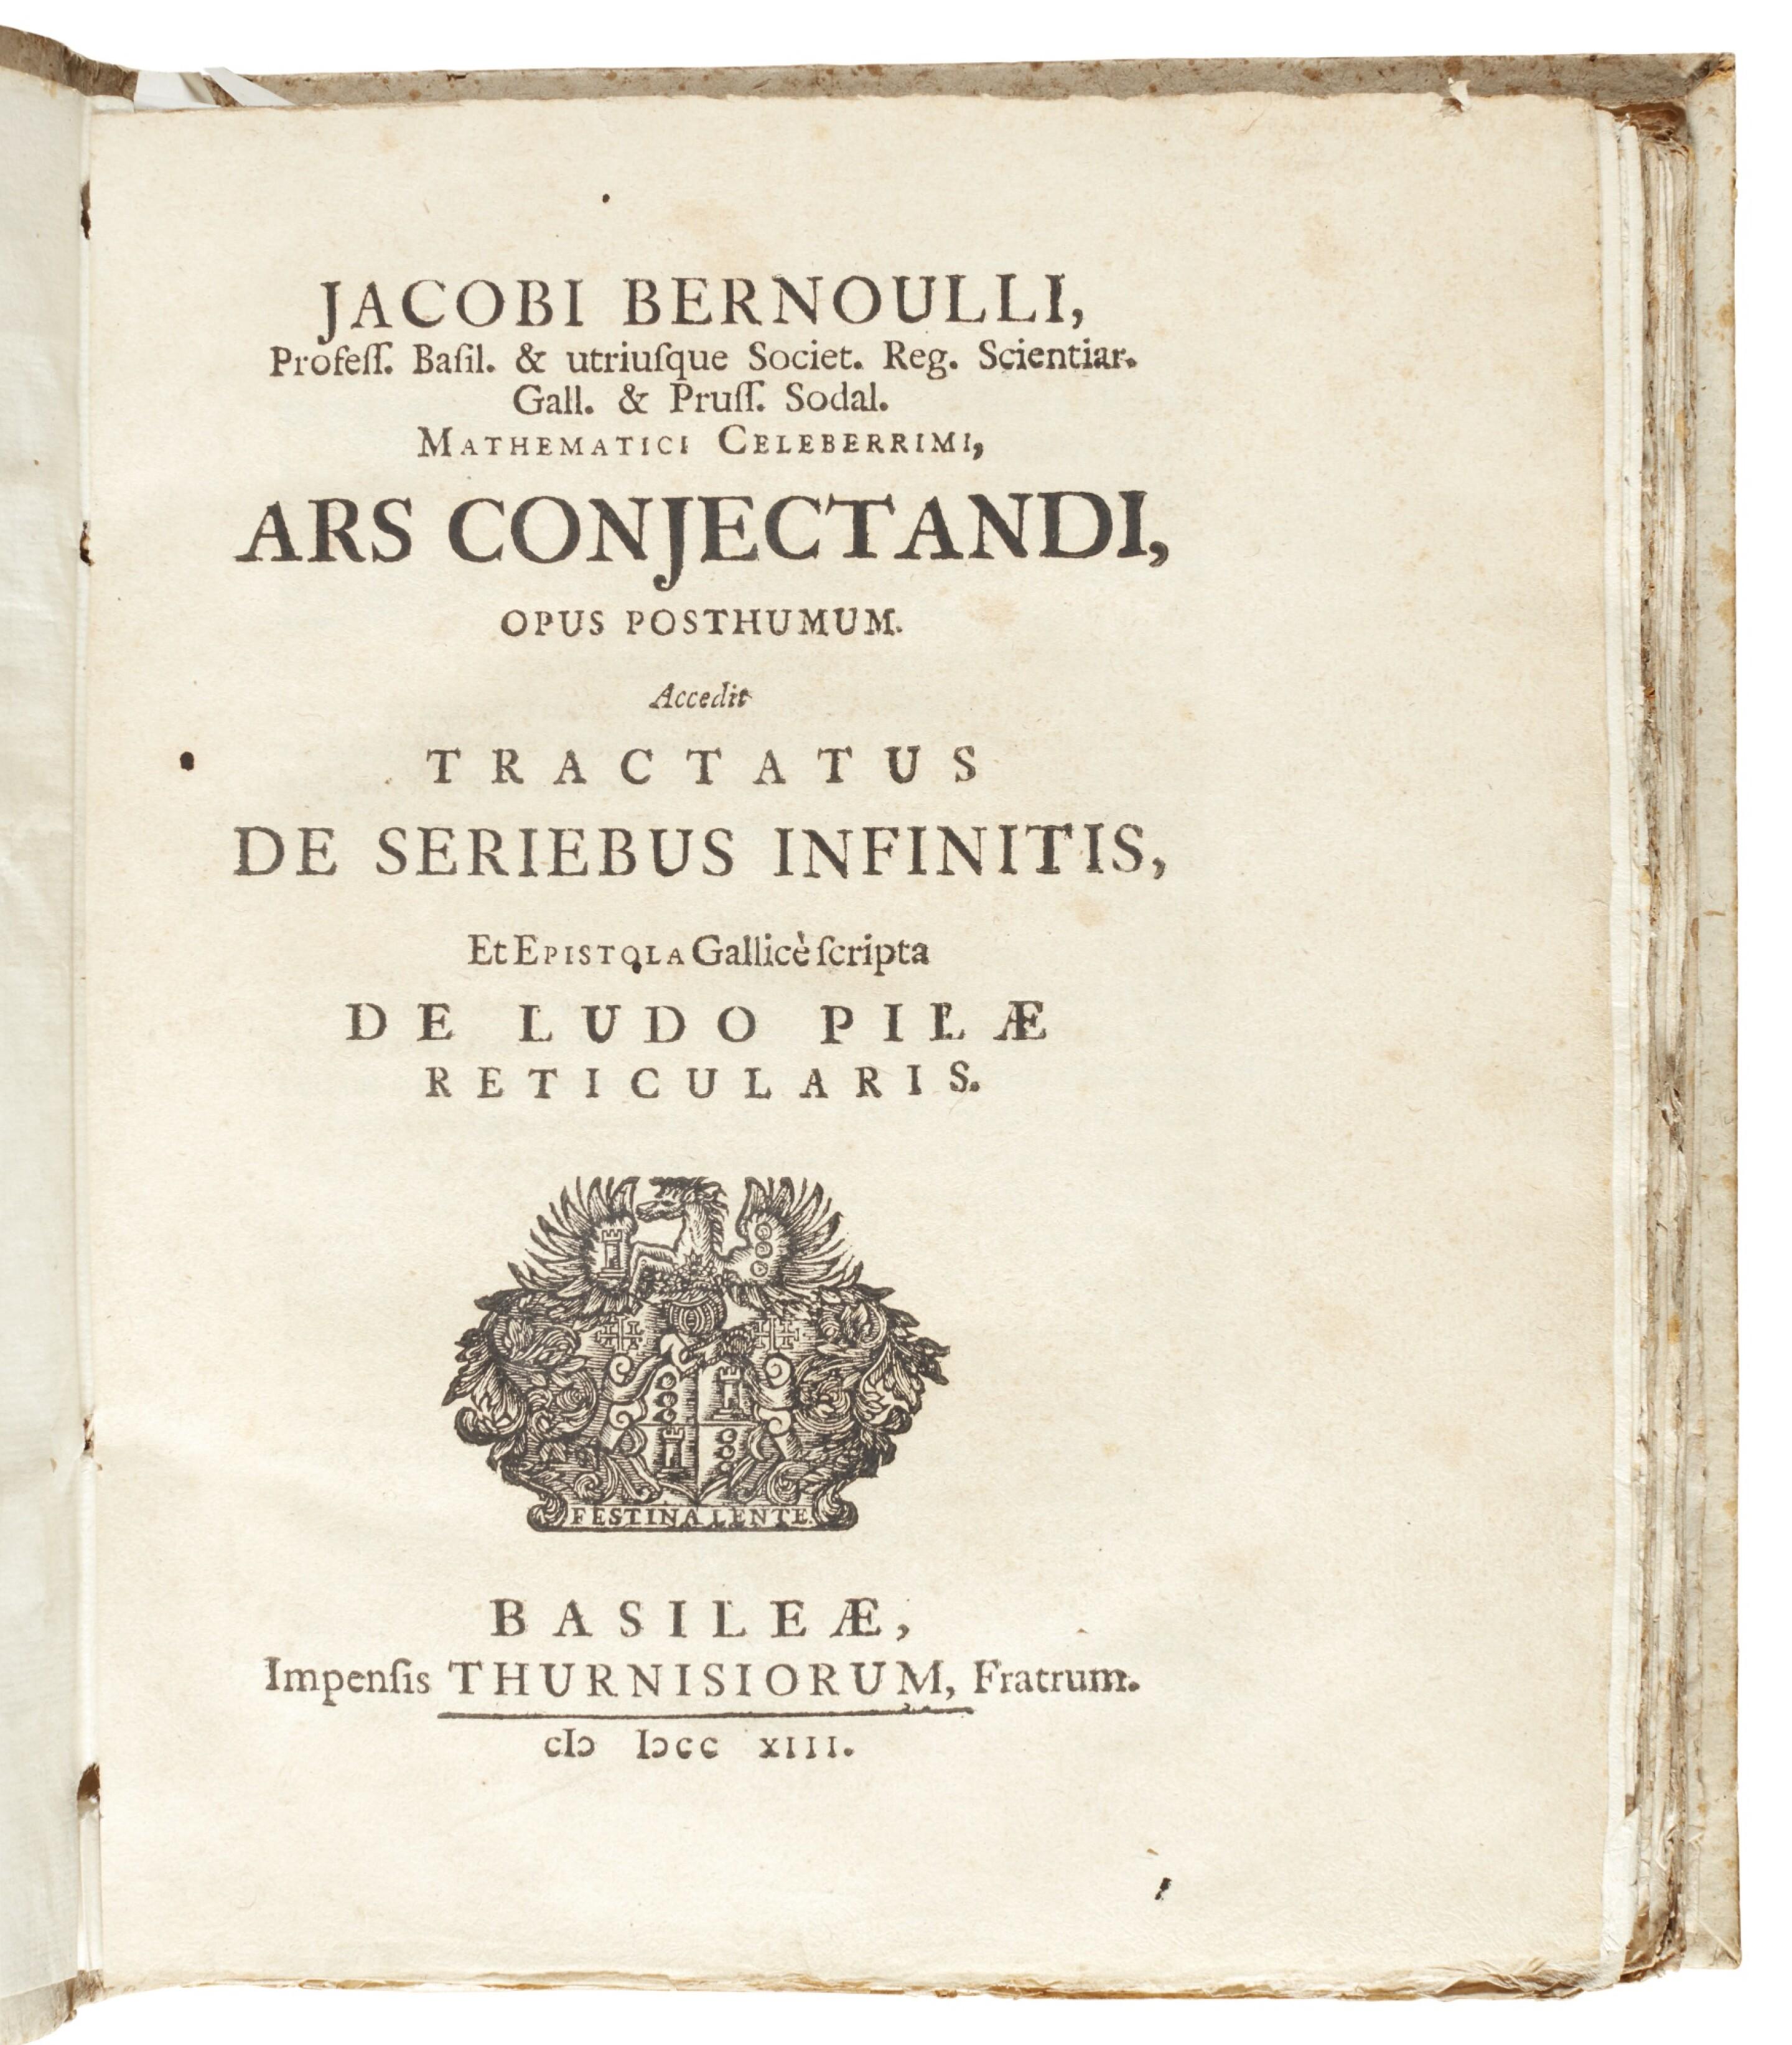
Jacob Bernoulli(1655—1705)
瑞士数学家,Bernoulli 家族的重要成员。他用了多年研究如何把机会游戏中的数学推广到现实生活中的不确定问题。
其著作 Ars Conjectandi(《推测术》)于他去世后,在1713年出版。
这本书的重要性,不仅仅在于它包含后来被称为大数定律的结果。
更值得关注的是 Bernoulli 试图解决的问题。
在他的时代,数学家能够计算理想赌博中的机会,因为游戏规则通常已知。
但现实世界并不会事先告诉我们概率。
例如:
某种疾病的致死机会有多大?
某一人口中的某种特征占多大比例?
一个自然现象在给定条件下会以怎样的频率出现?
我们能不能通过重复观察,逐渐认识这些未知的比例?
Bernoulli 在《推测术》中正是试图把赌博的数学扩展到民事、道德和经济问题;他的大数定律为从重复观察推断未知机会提供了数学依据。历史学家 Edith Dudley Sylla 和 Ian Hacking 都特别强调了这项工作中从赌博走向经验推断的意义。〔11, 12, 13〕
但这里出现了一种表面上的悖论。
如果我们本来不知道 p,又怎么能够证明观察频率会越来越接近 p?
我们似乎需要先知道概率,才能证明通过观察发现概率是合理的。
这就是 Bernoulli 所面对的核心数学问题。
2.3.1 从一个已知比例的罐子开始
考虑一个罐子,里面有 r 个红球与 s 个黑球。
每次随机取出一个球,记录颜色,然后把球放回并重新混合。
假设每个球被取出的机会相等。
那么抽到红球的概率是
p=\frac{r}{r+s}.进行 n 次独立重复抽取。
定义
X_i=\mathbf1_{\{\text{第 }i\text{ 次抽到红球}\}}.红球出现的次数为
S_n=X_1+\cdots+X_n.于是经验频率为
\widehat p_n=\frac{S_n}{n}.我们想要研究的不是某一个有限 n 下它是否恰好等于 p。
因为即使 p=1/2,也完全可能连续十次抽到红球。
真正的问题是:
对于任意给定的精度 \varepsilon>0,当实验次数越来越多时,
|\widehat p_n-p|<\varepsilon能否以越来越高的概率成立?
在现代数学语言中,我们希望证明:
\boxed{
P_p\left(
\left|\frac{S_n}{n}-p\right|>\varepsilon
\right)\longrightarrow0.
}
这就是 Bernoulli 大数定律的现代形式。
更精确地说,这表达的是依概率收敛:
\boxed{
\widehat p_n\xrightarrow{P_p}p.
}
Bernoulli 证明了这一思想的早期严格形式,并且不仅关心极限,还研究怎样使偏差概率小于预先指定的数值。他使用的论证建立在二项分布与组合数学上,而不是我们接下来采用的现代方差不等式。〔14, 13〕
2.4 为什么随机误差能够消失?
现在,我们暂时离开历史,使用现代数学重新证明这一现象。
这里有一件非常值得思考的事情。
每一次抛掷都存在随机性。
即使进行了百万次实验,第一百万零一次结果仍然可能是正面或反面。
如果个别结果中的随机性不会消失,为什么它们的平均却能够变得越来越稳定?
答案隐藏在期望和方差的不同性质中。
第一步:从总次数走向平均
因为
X_i\sim\operatorname{Bernoulli}(p),所以
\mathbb E_p[X_i]
=
1\cdot p+0\cdot(1-p)
=p.
因此
\mathbb E_p[\widehat p_n]
=
\mathbb E_p\left[\frac1n\sum_{i=1}^nX_i\right]
=p.
这说明,经验频率的期望始终等于真实概率。
但我们不能因此宣称经验频率会接近真实概率。
因为对于 n=1,
\widehat p_1\in\{0,1\},它的期望仍然是 p,却可能与 p 相差很远。
期望告诉我们随机量的平均位置,但不能单独告诉我们它围绕平均位置波动得有多剧烈。
这迫使我们研究波动本身。
第二步:用方差衡量波动
对 Bernoulli 随机变量,
X_i^2=X_i.因此
\begin{aligned}
\operatorname{Var}_p(X_i)
&=\mathbb E_p[X_i^2]-(\mathbb E_p[X_i])^2\\
&=p-p^2\\
&=p(1-p).
\end{aligned}
接下来考虑平均值的方差。
一般而言,
\operatorname{Var}\left(\sum_{i=1}^nX_i\right)
=
\sum_{i=1}^n\operatorname{Var}(X_i)
+
2\sum_{i<j}\operatorname{Cov}(X_i,X_j).
由于我们假设各次抽取相互独立,
\operatorname{Cov}(X_i,X_j)=0,\qquad i\ne j.于是
\operatorname{Var}_p(S_n)=np(1-p).因此
\boxed{
\operatorname{Var}_p(\widehat p_n)
=
\frac{p(1-p)}n.
}
这一步是整个证明的核心。
如果只看成功次数 S_n,其方差随着 n 增大。
但如果看成功的相对频率 S_n/n,其方差反而按照 1/n 下降。
用标准差表示,这种波动的典型尺度是
\boxed{
\sqrt{\operatorname{Var}(\widehat p_n)}
=
\sqrt{\frac{p(1-p)}n}.
}理论值,取 p = 0.5;纵轴表示频率而非成功总次数。
查看母稿数值表
| n | 标准差 |
|---|---|
| 1 | 0.5 |
| 5 | 0.223607 |
| 10 | 0.158114 |
| 20 | 0.111803 |
| 50 | 0.070711 |
| 100 | 0.05 |
| 200 | 0.035355 |
| 500 | 0.022361 |
| 1000 | 0.015811 |
这里有一个重要的数学现象:
为了让标准差缩小到原来的一半,通常需要把样本量扩大到原来的四倍。
因为
\operatorname{SD}(\widehat p_n)\propto\frac1{\sqrt n}.这为后来统计推断中大量出现的 \sqrt n 尺度提供了最简单的例子。
当然,我们此时仅仅研究了二阶矩,还没有证明更精细的极限分布。
第三步:从平均平方误差走向概率结论
我们已经知道
\mathbb E_p[(\widehat p_n-p)^2]
=
\frac{p(1-p)}n.
但是大数定律要求控制的是
P_p(|\widehat p_n-p|\ge\varepsilon).如何把一个关于期望的结论转化为关于概率的结论?
注意,对于任意实数 y,
\mathbf1_{\{|y|\ge\varepsilon\}}
\le\frac{y^2}{\varepsilon^2}.
因此
\begin{aligned}
P_p(|\widehat p_n-p|\ge\varepsilon)
&=\mathbb E_p\left[
\mathbf1_{\{|\widehat p_n-p|\ge\varepsilon\}}
\right]\\
&\le
\frac{\mathbb E_p[(\widehat p_n-p)^2]}
{\varepsilon^2}\\
&=\frac{p(1-p)}{n\varepsilon^2}.
\end{aligned}
因为
p(1-p)\le\frac14,所以
\boxed{
P_p(|\widehat p_n-p|\ge\varepsilon)
\le\frac1{4n\varepsilon^2}.
}
对每个固定的 \varepsilon>0,右边都趋于零。
于是
\boxed{\widehat p_n\xrightarrow{P_p}p.}证毕。
这个证明非常简短,但它揭示了深刻的结构。
我们并没有让单独的随机事件变得确定。
我们只是证明,当足够多的独立随机事件被平均时,平均值的波动会逐渐受到越来越严格的约束。
随机性并没有消失;消失的是平均值偏离其中心的可能性。
2.4.1 独立性究竟在哪里发挥作用?
重新观察刚才的证明。
期望部分:
\mathbb E\left[\frac1n\sum X_i\right]
=
\frac1n\sum\mathbb E[X_i]
并不要求独立性。
真正使用独立性的是
\operatorname{Var}\left(\sum X_i\right)
=
\sum\operatorname{Var}(X_i).
如果随机变量之间存在相关性,那么协方差可能无法忽略。
例如,假设
X_1=X_2=\cdots=Y且 Y\sim\operatorname{Bernoulli}(p)。
此时所有实验结果完全相同。
虽然每个 X_i 的边际分布仍然是 Bernoulli(p),但
\widehat p_n=Y对所有 n 都成立。
所以根本没有因为重复次数增多而产生稳定性。
这说明大数定律真正依赖的并不是“我们做了很多次实验”这一表面事实。
更本质的是:不同实验之间的依赖结构必须足够弱,使平均误差能够受到控制。
独立性是一种特别有效的充分条件,却并不是大数定律唯一可能的假设。
将来研究遍历理论、鞅和依赖随机过程时,我们会不断回到这个问题。
2.5 大数定律回答了什么?又没有回答什么?
现在,我们已经证明了一个非常重要的结论:
\widehat p_n\xrightarrow{P_p}p.表面上看,这似乎已经解决了未知概率的推断问题。
如果我们观察足够多的实验,经验频率就会接近真实概率。
但这里隐藏着一个逻辑上的困难。
大数定律的陈述是:
假设真实概率为
p,则经验频率大概率接近p。
而我们想要得到的结论是:
我已经观察到经验频率为
0.7,因此真实概率应该接近0.7。
这两个陈述看起来相似,却并不是同一个逻辑命题。
一个是从模型预测观察。
另一个是从观察推断模型。
我们不能未经证明,就将一个条件概率陈述的方向倒过来。
2.5.1 如何将大数定律真正变成推断方法?
幸运的是,大数定律中的概率不等式提供了更严格的办法。
之前证明
P_p(|\widehat p_n-p|\ge\varepsilon)
\le\frac1{4n\varepsilon^2}.
注意,这个不等式对所有 p\in[0,1] 都成立。
因此,即使我们不知道 p,也能够提前规定一个容许的错误概率 \delta\in(0,1)。
令
\varepsilon_n=\sqrt{\frac1{4n\delta}}.那么
P_p\left(
|\widehat p_n-p|\le\varepsilon_n
\right)\ge1-\delta.
现在定义一个由观察数据决定的随机区间:
\boxed{
C_n=
\left[
\widehat p_n-\varepsilon_n,
\widehat p_n+\varepsilon_n
\right]\cap[0,1].
}
于是对任何真实参数 p,
\boxed{
P_p(p\in C_n)\ge1-\delta.
}
这是一种具有严格覆盖率保证的参数推断程序。
例如,假设我们进行了100次独立抛掷,观察到70次正面。
取 \delta=0.05。
则
\varepsilon_{100}
=
\sqrt{\frac1{4(100)(0.05)}}
\approx0.224.
因此得到区间
C_{100}\approx[0.476,0.924].这个区间确实非常宽。
但它的优点在于,我们没有借助任何关于未知 p 的事先猜测,就得到了至少95%的覆盖率保证。
现代统计学可以利用更精细的不等式或精确二项分布方法大幅改善这一结果。上面的构造只是为了清楚展示数学原理。
2.5.2 一个微妙的哲学问题
现在假设我们确实观察到了70次正面,已经算出这个固定区间。
我们可以说:
“真实参数落在这个区间中的概率至少为95%”吗?
在刚才的数学框架下,不能直接这样解释。
因为 p 被看作固定但未知的参数。
在实验进行前,区间 C_n 是随机的。它可能包含真实参数,也可能不包含。
而一旦我们观察到具体数据,区间便已经确定。
覆盖率的意义是:如果反复使用这一构造方法,那么在具有相同真实参数的重复实验中,至少95%的区间会包含它。
它不是直接赋予这个已经固定的参数一个95%的条件概率。
不过,从人类面对未知事物的实际处境来看,另一个问题几乎不可避免:
既然我们不知道 p,为什么不能直接给 p 本身分配一种概率?
例如:
P(0.6<p<0.8\mid\text{观察数据})=?这就需要一种不同于上述固定参数模型的数学结构。
我们必须把“未知的概率”本身作为可以进行概率推断的对象。
在历史上,Thomas Bayes 的工作正是朝这个方向迈出了关键一步。
2.6 Thomas Bayes:概率本身也可以是不确定的吗?
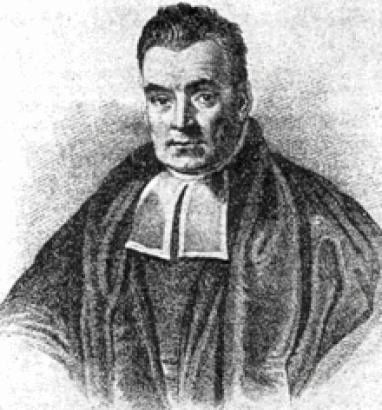
Thomas Bayes(约1701—1761)
英国牧师与数学家。
他的论文 An Essay towards Solving a Problem in the Doctrine of Chances 在他去世后,由 Richard Price 整理并提交英国皇家学会,收入1763年卷的《哲学汇刊》。
这篇论文的出发点与我们刚才的问题惊人地接近。
假设某件事已经发生了若干次,也未发生若干次。
如果我们只知道这些观察结果,是否可以计算该事件发生概率位于两个给定数值之间的机会?
Bayes 所研究的,正是如何对一个未知的成功概率进行区间概率推断。〔15, 16, 17〕
这里需要作一个历史上的区分。
今天我们熟悉的 Bayes 公式,
P(H\mid D)
=
\frac{P(D\mid H)P(H)}{P(D)},
并不是他的论文中首次出现的、完全独立于此前数学发展的条件概率恒等式。
Bayes 的重要贡献在于对未知机会的逆向问题进行具体的概率分析。
而且,他不是简单宣布“所有未知参数都应该均匀分布”,而是构造了一个借助随机落球位置产生未知概率的物理模型,从而为他的特殊问题赋予初始概率结构。历史学家对其原始论证与后来 Bayes 主义的关系也存在细致讨论。〔18, 19, 20〕
我们现在用现代概率语言重建这种思路。
2.6.1 一个新的实验:先随机决定硬币的偏向
想象我们设计了一个装置。
第一步,在区间 [0,1] 中均匀随机选择一个数字。
把这个数字记为
\Theta.因此
\Theta\sim\operatorname{Uniform}(0,1).第二步,利用这个随机选出的数字制造一枚硬币,使它出现正面的概率恰好等于 \Theta。
第三步,用这枚硬币进行许多次相互独立的抛掷。
注意,每次抛掷时,我们并不会重新制造一枚硬币。
\Theta 一旦选定,就成为这枚硬币的固定偏向。
所以我们得到的是下面这个分层模型:
\boxed{
\begin{aligned}
\Theta&\sim\operatorname{Uniform}(0,1),\\
X_i\mid\Theta=\theta
&\overset{\mathrm{i.i.d.}}{\sim}
\operatorname{Bernoulli}(\theta).
\end{aligned}
}
这个模型与上一节存在一个非常重要的区别。
此前,p 是固定而未知的数字。
现在,\Theta 是一个真正的随机变量。
所以我们可以合法地询问:
P(\Theta\in[a,b]).在观察数据之前,
P(\Theta\in[a,b])=b-a,
\qquad 0\le a\le b\le1.
这种分布在现代术语中称为先验分布(prior distribution)。
但在我们的装置中,它并非仅仅表达主观信念。
它还有一种明确的物理解释:我们确实通过均匀随机机制制造了一个未知参数。
这也说明,给未知参数分配概率并不必然意味着采用主观概率解释;其含义取决于模型如何建立。
2.7 观察会怎样改变未知概率的分布?
现在,假设我们利用这枚硬币抛掷十次,观察到七次正面。
定义
S_{10}=X_1+\cdots+X_{10}.已知
S_{10}=7.我们希望计算
P(\Theta\in[a,b]\mid S_{10}=7).首先,在给定 \Theta=\theta 的情况下,十次抛掷是独立的,因此
P(S_{10}=7\mid\Theta=\theta)
=
\binom{10}{7}\theta^7(1-\theta)^3.
现在使用条件概率的思想。
若先验密度为 \pi(\theta),则在观察到数据 D 后,后验密度应满足
\pi(\theta\mid D)
=
\frac{P(D\mid\theta)\pi(\theta)}
{\int_0^1P(D\mid u)\pi(u)\,du}.
在我们构造的均匀先验模型中,
\pi(\theta)=1,\qquad 0<\theta<1.于是
\pi(\theta\mid S_{10}=7)
=
\frac{\theta^7(1-\theta)^3}
{\int_0^1u^7(1-u)^3\,du}.
分母是一个 Beta 积分:
\int_0^1u^7(1-u)^3\,du
=
B(8,4)
=
\frac{7!\,3!}{11!}.
所以
\boxed{
\Theta\mid S_{10}=7
\sim\operatorname{Beta}(8,4).
}
这是一个非常漂亮的结果。
我们从不知道硬币偏向多少开始。
观察了七次成功与三次失败之后,没有得到一个确定的参数值。
相反,我们得到了一整个关于未知参数的概率分布。
它描述的是:在我们的先验模型与已经观察的数据之下,不同参数值具有怎样的条件概率权重。
这里,我们第一次不再把概率仅仅当作描述随机实验结果的工具。
我们开始用概率描述对未知规律本身的不确定性。
2.8 一个惊人的发现:关于未知概率的平均,居然可以预测未来
我们已经得到:
\Theta\mid S_{10}=7\sim\operatorname{Beta}(8,4).那么,下一次抛掷出现正面的概率是多少?
一个直接的想法是使用观察频率:
\frac7{10}=0.7.但现在,我们拥有关于 \Theta 的整个后验分布。
下一次抛掷的条件概率满足
P(X_{11}=1\mid\Theta=\theta,S_{10}=7)=\theta.因此,根据条件概率的全概率法则,
\begin{aligned}
P(X_{11}=1\mid S_{10}=7)
&=\int_0^1\theta\,
\pi(\theta\mid S_{10}=7)\,d\theta\\
&=\mathbb E[\Theta\mid S_{10}=7].
\end{aligned}
而 Beta 分布的期望为
\mathbb E[\Theta\mid S_{10}=7]
=
\frac8{8+4}.
所以
\boxed{
P(X_{11}=1\mid S_{10}=7)=\frac23.
}
这与 0.7 并不完全相同。
为什么?
因为我们不仅使用了十次观察,还使用了观察之前关于 \Theta 的概率模型。
在均匀先验下,观察到 n 次试验中 k 次成功后,
\Theta\mid S_n=k
\sim\operatorname{Beta}(k+1,n-k+1).
因此
\boxed{
P(X_{n+1}=1\mid S_n=k)
=
\frac{k+1}{n+2}.
}
这一表达式通常称为 Laplace 的继承法则(rule of succession),在现代形式下对应均匀先验的 Beta–Bernoulli 预测模型。Laplace 在十八世纪末至十九世纪初进一步系统发展了逆概率方法。〔21〕
例如,假设连续十次都是正面,那么下一次仍然出现正面的预测概率是
\frac{11}{12}.而不是 1。
这并不是数学定理告诉我们任何硬币都不可能永远出现正面,而是我们所选定的先验模型与观察共同产生的结果。
我们现在看到了两种不同的平均:
\boxed{
\begin{aligned}
\text{经验频率:}&\quad \frac{k}{n},\\[3pt]
\text{后验预测:}&\quad \frac{k+1}{n+2}.
\end{aligned}
}
并且
\frac{k+1}{n+2}-\frac{k}{n}
=
\frac{n-2k}{n(n+2)}.
所以
\left|
\frac{k+1}{n+2}-\frac{k}{n}
\right|
\le\frac1{n+2}.
当 n\to\infty 时,两者之间的差异趋于零。
这似乎在提示我们:大样本下,经验频率与贝叶斯预测之间存在某种联系。
但它们真正的关系,比这个简单的代数式还要深刻。
2.9 为什么我们竟然创造出了依赖性?
现在出现了本章最值得深入思考的数学现象之一。
回忆我们的分层模型:
\Theta\sim\operatorname{Uniform}(0,1),X_i\mid\Theta
\overset{\mathrm{i.i.d.}}{\sim}
\operatorname{Bernoulli}(\Theta).在给定 \Theta 后,所有抛掷都是独立的。
那么,不给定 \Theta 时,抛掷是否仍然独立?
我们先计算
P(X_1=1).通过对未知参数积分,
\begin{aligned}
P(X_1=1)
&=\int_0^1P(X_1=1\mid\Theta=\theta)\,d\theta\\
&=\int_0^1\theta\,d\theta\\
&=\frac12.
\end{aligned}
因此,单独观察任何一次抛掷,正面的概率都是 1/2。
现在计算连续两次正面的概率。
\begin{aligned}
P(X_1=1,X_2=1)
&=\int_0^1
P(X_1=1,X_2=1\mid\Theta=\theta)\,d\theta\\
&=\int_0^1\theta^2\,d\theta\\
&=\frac13.
\end{aligned}
但如果两次抛掷独立,我们应该得到
P(X_1=1)P(X_2=1)=\frac14.事实上,
\boxed{
P(X_1=1,X_2=1)=\frac13\ne\frac14.
}
所以它们并不独立!
更加令人意外的是:
\begin{aligned}
P(X_2=1\mid X_1=1)
&=\frac{P(X_1=1,X_2=1)}{P(X_1=1)}\\
&=\frac{1/3}{1/2}\\
&=\frac23.
\end{aligned}
也就是说,观察到第一次为正面后,我们对第二次出现正面的预测,从 1/2 上升到了 2/3。
为什么会这样?
第一次抛掷并没有改变硬币本身的物理结构。
但它改变了我们对于未知 \Theta 的认识。
而由于所有抛掷都共享同一个 \Theta,对这个共同参数的认识改变,也会改变其他抛掷的预测概率。
条件独立,并不意味着无条件独立。
我们可以用协方差进一步看清这种结构。
由于
\mathbb E[X_i\mid\Theta]=\Theta,且在给定 \Theta 时 X_i,X_j 独立,因此对 i\ne j,
\begin{aligned}
\operatorname{Cov}(X_i,X_j)
&=\mathbb E[X_iX_j]-\mathbb E[X_i]\mathbb E[X_j]\\
&=\mathbb E[\Theta^2]-(\mathbb E[\Theta])^2\\
&=\operatorname{Var}(\Theta).
\end{aligned}
对于均匀分布,
\boxed{
\operatorname{Cov}(X_i,X_j)=\frac1{12}>0.
}
因此,这个模型中各次抛掷的相关性,正是由共同的未知参数产生的。
这是一种极其重要的数学结构。
我们从条件独立的简单随机试验开始,通过混合不同参数下的概率分布,竟然产生了一个整体上具有依赖性的随机序列。
而且,这个序列还有一个特殊性质。
对于任意正整数 n,任意 x_1,\ldots,x_n\in\{0,1\},设
k=\sum_{i=1}^n x_i.那么
\begin{aligned}
&P(X_1=x_1,\ldots,X_n=x_n)\\
&\qquad =
\int_0^1\theta^k(1-\theta)^{n-k}\,d\theta.
\end{aligned}
右侧只依赖于成功总次数 k,不依赖于成功与失败的具体排列顺序。
所以对任意排列 \sigma,
\boxed{
(X_1,\ldots,X_n)
\overset d=
(X_{\sigma(1)},\ldots,X_{\sigma(n)}).
}
我们得到了一个交换的(exchangeable)随机序列。
这不是独立性,却包含一种比普通的边际同分布更强的对称结构。
将来,在研究 de Finetti 定理时,我们会重新回到这里。
对于无限 Bernoulli 序列,de Finetti 定理将以令人惊讶的方式说明,交换性如何与条件独立混合模型联系起来。
但现在,我们先保留这个发现。
因为它揭示了一个过去不容易察觉的事实:
对随机系统中未知结构的处理方式,本身可以决定我们观察到的随机变量之间具有怎样的依赖关系。
2.10 我们是否只是把“不知道”换成了另一种假设?
故事似乎已经非常完整。
我们不知道硬币的真实偏向。
于是引入随机参数 \Theta。
观察数据后,利用条件概率计算后验分布。
最后,用后验分布预测未来。
但是,最初的
\Theta\sim\operatorname{Uniform}(0,1)究竟凭什么成立?
在前面的物理实验中,我们明确规定了一个均匀随机生成参数的装置。
因此这种分布有模型依据。
可如果面对的是现实中捡到的一枚硬币,我们并不知道它的偏向是如何形成的。
选择均匀先验,本身就成为了一个需要论证的建模决定。
甚至,“均匀”这个词也没有想象中简单。
假设我们不研究 \Theta,而改为研究
U=\Theta^2.如果 \Theta\sim\operatorname{Uniform}(0,1),那么对于 0\le u\le1,
\begin{aligned}
P(U\le u)
&=P(\Theta^2\le u)\\
&=P(\Theta\le\sqrt u)\\
&=\sqrt u.
\end{aligned}
所以 U 的密度为
\boxed{
f_U(u)=\frac1{2\sqrt u},\qquad 0<u<1.
}
这显然不是均匀分布。
但如果我们原本就认为 U=\Theta^2 才是适当的参数,然后对 U 赋予均匀先验,那么转换回 \Theta 时,又会得到另外一种先验分布。
因此:
\boxed{
\text{对 }\Theta\text{ 均匀}
\quad\not\Longleftrightarrow\quad
\text{对 }\Theta^2\text{ 均匀}.
}
这不是一个单纯的技术问题。
它揭示了更深层的困难。
当我们声称对一个未知参数“没有任何偏好”时,必须回答:
我们究竟是相对于哪一种参数化方式,没有偏好?
在连续空间中,均匀性不是一种完全脱离测度和坐标描述而存在的性质。
我们原本想用均匀先验来表达缺乏知识,却发现这种表达本身依赖于我们选择的数学语言。
这与第一章中讨论的对称性形成了呼应。
当概率来自物理对称性时,对称性可以限制概率分配。
但当概率被用于表达知识的不完整时,我们又必须问:为什么要采用某种特定的不变性原则?
这一问题将贯穿后来的客观 Bayes 方法、参数变换、不变测度和统计决策理论。
2.11 Bernoulli 与 Bayes:两种思想真的相互矛盾吗?
现在,我们终于可以重新审视本章最初的两个问题。
Bernoulli 的路线,是先假设存在某个固定概率 p,然后研究通过重复观察能否估计它。
在这种框架下,我们研究
P_p\left(
|\widehat p_n-p|>\varepsilon
\right).
而 Bayes 式的分层模型,则首先给予未知参数一个概率分布,再根据数据更新它。
此时研究的是
P(\Theta\in A\mid X_1,\ldots,X_n).两种方法对“未知参数”的数学处理不同。
但是,它们之间有一个极其重要的共同点:
它们都希望通过观察逐渐获得对未知规律的认识。
我们甚至可以在刚才的 Beta–Bernoulli 模型中,直接观察到两种思想的联系。
由于给定 \Theta=\theta 时,X_i 独立同分布,我们可以应用相应的强大数定律得到
P\left(
\left.
\lim_{n\to\infty}\frac{S_n}{n}=\theta
\,\right|\,\Theta=\theta
\right)=1
对于先验几乎处处的 \theta 成立。
于是,对 \Theta 的分布积分,便得到
\boxed{
\frac{S_n}{n}\xrightarrow{\mathrm{a.s.}}\Theta.
}
另一方面,我们刚才已经证明后验均值满足
\left|
\mathbb E[\Theta\mid S_n]-\frac{S_n}{n}
\right|
\le\frac1{n+2}.
因此
\boxed{
\mathbb E[\Theta\mid S_n]
\xrightarrow{\mathrm{a.s.}}\Theta.
}
这说明,在这个具体模型中,随着观察数据不断累积,后验均值会趋向实际产生数据的那个随机参数值。
而它还包含另一个后世才被系统揭示的结构。
因为
M_n=
\mathbb E[\Theta\mid X_1,\ldots,X_n],
所以根据条件期望的塔性质,
\mathbb E[M_{n+1}\mid X_1,\ldots,X_n]=M_n.因此 (M_n) 是一个有界鞅。
这是一个很值得记住的联系。
我们起初只是在研究怎样预测下一次抛掷。
但同一个预测过程,在现代概率论中,竟然自然地成为了一个鞅。
这意味着未来我们在研究条件期望与随机过程时,将能够重新解释本章中这些关于学习和信息积累的计算。
本章结语:从偶然的计算到知识的形成
第一章,我们研究的是:
如果已经知道机会,应该如何计算结果?
第二章则向前走了一步:
如果不知道机会,我们能否通过观察认识它?
Bernoulli 发现,独立重复试验能够让经验频率稳定地接近隐藏的概率。
Bayes 所研究的逆向问题则进一步展示,可以通过构造未知概率的概率模型,再借助观察来更新推断。
这两个方向后来发展出了十分丰富、也存在长期争论的统计思想。
但它们共同揭示了一件事。
概率论不只是关于偶然结果的数学。
它也逐渐成为了一门研究人类如何在不确定的世界中获得可靠知识的数学。
这里的“可靠”当然不是指每一次推断必然正确,而是指我们能够明确说明:推断依赖什么假设、拥有什么概率保证、可能如何失败。
然而,我们的故事仍然存在一处没有解决的困难。
我们证明了:
\frac{S_n}{n}\xrightarrow{P}p.但这个式子只是说,偏离某个固定精度的概率会趋于零。
它没有告诉我们:
当 n 很大但仍然有限时,经验频率究竟怎样围绕 p 波动?
如果我们想更精确地预测这些波动,就必须研究
\sqrt n(\widehat p_n-p).为什么会出现 \sqrt n?
为什么大量看似完全不同的随机现象,在适当标准化后,会表现出几乎相同的分布形状?
这将把我们引向概率论历史上的另一个重要发现:
正态分布与中心极限定理。
但在继续之前,我们还需要追溯一个更古老的数学问题:为什么组合数
\binom nk会在重复实验中产生一种近似钟形的曲线?又为什么这种曲线最终能够超越骰子、硬币和二项分布,成为描述自然误差的重要工具?
下一章:第三章《钟形曲线的诞生——从二项式到正态分布》
《偶然的数学》· 第一卷第二章 · 工作稿 v0.1