Haobai Wang · 公开阅读版 · ch06-zh-2663ea1806fc
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 2663ea1806fc26d134cb82bf112dad89a38d7d5d4fb3e9ad087fae745a15dc33
《偶然的数学》
第二卷 · 无限世界中的概率
第六章:平均值的重生——从加权求和到 Lebesgue 积分
为什么一个关于赌博收益的简单平均,最终需要一种全新的积分理论?
第五章,我们经历了一次数学思想上的重大转变。
为了在无限集合上定义概率,我们不得不放弃一个看似自然的愿望:并不是所有集合都能够拥有与区间长度相容的测度。
于是,我们建立了概率空间
(\Omega,\mathcal F,P).概率不再只是“有利结果数除以总结果数”,而是定义在 \sigma-代数上的一种满足可数可加性的测度。
这让我们终于可以严格研究连续分布、无限随机序列,以及 Brownian motion 这样复杂的随机对象。
但是,回顾概率论的发展,我们会发现另一个几乎同样重要的数学概念,一直伴随着我们。
它就是期望。
第一章,我们已经用期望公平地分配了一场没有结束的赌博。
第二章,我们利用期望估计未知参数。
第三章,我们利用均值和方差研究了正态极限。
第四章,我们甚至计算了整个随机过程的平方增量之和的期望。
但我们一直没有真正回答:
期望为什么应该以我们熟悉的方式定义?当样本空间不再有限时,期望究竟是什么?
现在,我们已经拥有了测度。
也许,正是时候从头重新理解平均值。
6.1 一切仍然从公平赌博开始
想象我们再次回到第一章。
一张赌博契约具有三种可能的收益:
X=
\begin{cases}
10,&\text{概率为 }1/2,\\
20,&\text{概率为 }1/3,\\
-5,&\text{概率为 }1/6.
\end{cases}
如果我们想用一个数来表示这张契约的平均收益,最自然的计算方式是
\begin{aligned}
\mathbb E[X]
&=10\cdot\frac12
+20\cdot\frac13
-5\cdot\frac16\\
&=\frac{65}{6}.
\end{aligned}
这里,我们进行的是加权求和:
\boxed{
\mathbb E[X]=\sum_i x_ip_i.
}
但是,我们应该更加仔细地观察这个表达式。
它实际上包含两个完全不同的数学对象。
第一个是收益:
x_i.第二个是每一种收益对应的概率权重:
p_i.期望就是把这两者结合起来的一种数学运算。
现在,把它写成另外一种形式。
设样本空间为
\Omega=\{\omega_1,\omega_2,\omega_3\},并定义随机变量
X(\omega_1)=10,\quad
X(\omega_2)=20,\quad
X(\omega_3)=-5.
对应概率为
P(\{\omega_1\})=\frac12,\quad
P(\{\omega_2\})=\frac13,\quad
P(\{\omega_3\})=\frac16.
那么
\mathbb E[X]
=
\sum_{\omega\in\Omega}
X(\omega)P(\{\omega\}).
这个公式已经非常接近积分的思想。
因为我们所做的,其实是:
将一个定义在样本空间上的函数,按照某种集合大小的规则进行加权累加。
于是,一个新的问题出现了:
如果样本空间包含无限多个结果,我们能否把这种加权求和推广成某种积分?
6.1.1 从有限结果到连续结果
假设现在的收益不再只取三个数值。
我们在 [0,1] 中均匀随机选择一个实数 U,然后得到收益
X=U^2.第五章已经为我们建立了严格的均匀概率空间:
\Omega=[0,1],
\qquad P=\text{Lebesgue 长度测度}.
我们希望计算
\mathbb E[U^2].根据微积分知识,我们自然会写:
\mathbb E[U^2]
=
\int_0^1x^2\,dx
=
\frac13.
但这一步其实包含了一个尚未说明的假设:
为什么一个连续随机变量的平均值,应该等于函数在区间上的面积积分?
我们通常会解释说,可以把区间分成许多小部分。
例如:
0=x_0<x_1<\cdots<x_n=1.对于每个小区间
I_k=[x_{k-1},x_k],选取一个代表点 \xi_k。
那么期望似乎可以近似为
\sum_{k=1}^n\xi_k^2P(U\in I_k).由于 U 均匀分布,
P(U\in I_k)=x_k-x_{k-1}.于是
\mathbb E[U^2]
\approx
\sum_{k=1}^n\xi_k^2(x_k-x_{k-1}).
当网格越来越细时,这就变成了 Riemann 积分。
\boxed{
\mathbb E[U^2]
=
\int_0^1x^2\,dx.
}
这似乎说明:我们根本不需要创造任何新的积分理论。
既然微积分已经拥有 Riemann 积分,为什么不能直接把它用于所有随机变量?
答案是:因为 Riemann 积分依赖一种特殊的逼近方式。
当我们开始研究真正复杂的随机事件与函数时,这种方式会遇到无法解决的困难。
6.2 Riemann 积分究竟在做什么?
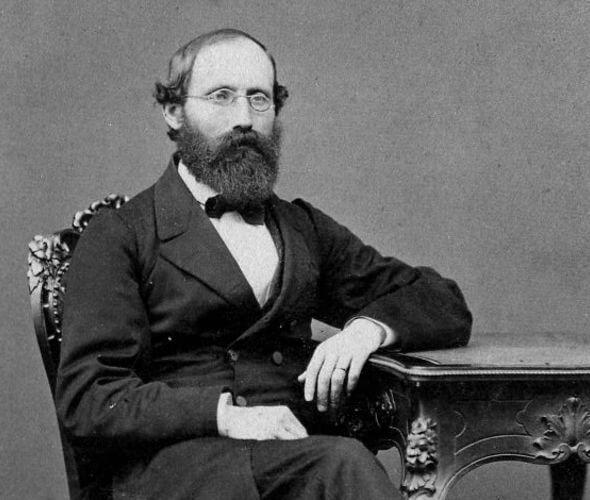
Bernhard Riemann(1826—1866)
德国数学家。1854年的积分研究中,他系统讨论了比连续函数更广泛的函数何时能够积分;相关成果于1867年发表。
后来 Darboux 在1875年发展了用上、下和表述 Riemann 可积性的经典方法。
Riemann 积分的直观思想十分简单。
我们有一个函数
f:[a,b]\to\mathbb R.希望计算曲线下面的有向面积。
为此,将横轴划分为许多小区间,并用矩形近似函数图像。
Riemann 积分:先切分定义域
矩形的宽度来自定义域划分,高度由各区间上的函数取值决定。
定义划分
\mathcal P=\{a=x_0<x_1<\cdots<x_n=b\}.对于有界函数 f,令
m_k=\inf_{x\in[x_{k-1},x_k]}f(x),M_k=\sup_{x\in[x_{k-1},x_k]}f(x).下和与上和分别为
L(f,\mathcal P)=
\sum_{k=1}^nm_k(x_k-x_{k-1}),
U(f,\mathcal P)=
\sum_{k=1}^nM_k(x_k-x_{k-1}).如果能够使
U(f,\mathcal P)-L(f,\mathcal P)任意小,那么 f 就是 Riemann 可积的。
这个定义背后有一个重要要求:
当我们把横轴划分得越来越细时,小区间内部函数的振荡必须能够得到充分控制。
对于连续函数,这当然没有问题。
因为连续函数在紧区间上一致连续。
但是对于一个处处不连续的函数呢?
事情就不一样了。
6.2.1 一个概率论中最自然、却无法 Riemann 积分的函数
回到第五章。
我们已经知道,在 [0,1] 上均匀选择实数时,
P(U\in\mathbb Q)=0.现在定义
f(x)=\mathbf1_{\mathbb Q\cap[0,1]}(x).也就是说:
f(x)=
\begin{cases}
1,&x\in\mathbb Q,\\
0,&x\notin\mathbb Q.
\end{cases}
这个函数通常称为 Dirichlet 函数。
从概率论的角度,它再普通不过了。
它只是事件
A=\{U\in\mathbb Q\}对应的指示函数。
我们希望它的期望等于事件的概率:
\mathbb E[\mathbf1_A]=P(A)=0.但如果尝试使用 Riemann 积分,会发生什么?
考虑任意划分
\mathcal P=\{0=x_0<\cdots<x_n=1\}.由于每个非退化小区间内既有有理数,也有无理数,
m_k=0,\qquad M_k=1.所以
L(f,\mathcal P)=0,而
U(f,\mathcal P)=1.无论网格多么细,
\boxed{
U(f,\mathcal P)-L(f,\mathcal P)=1.
}
因此 f 不是 Riemann 可积函数。
这里出现了一个真正的问题。
从概率论角度,这个随机变量的期望再清楚不过:
\mathbb E[f(U)]=0.但使用传统的 Riemann 积分,我们却无法给它赋予积分值。
我们不能简单地认为这个函数“太不规则,所以不值得研究”。
因为事件的指示函数是概率论中最基本的随机变量。
如果一种积分理论连可测事件的指示函数都无法普遍处理,那么它就不能成为现代概率论中期望的完整基础。
于是我们需要一种新的积分方法。
6.3 Lebesgue 的转变:不要先划分位置,而要先划分数值
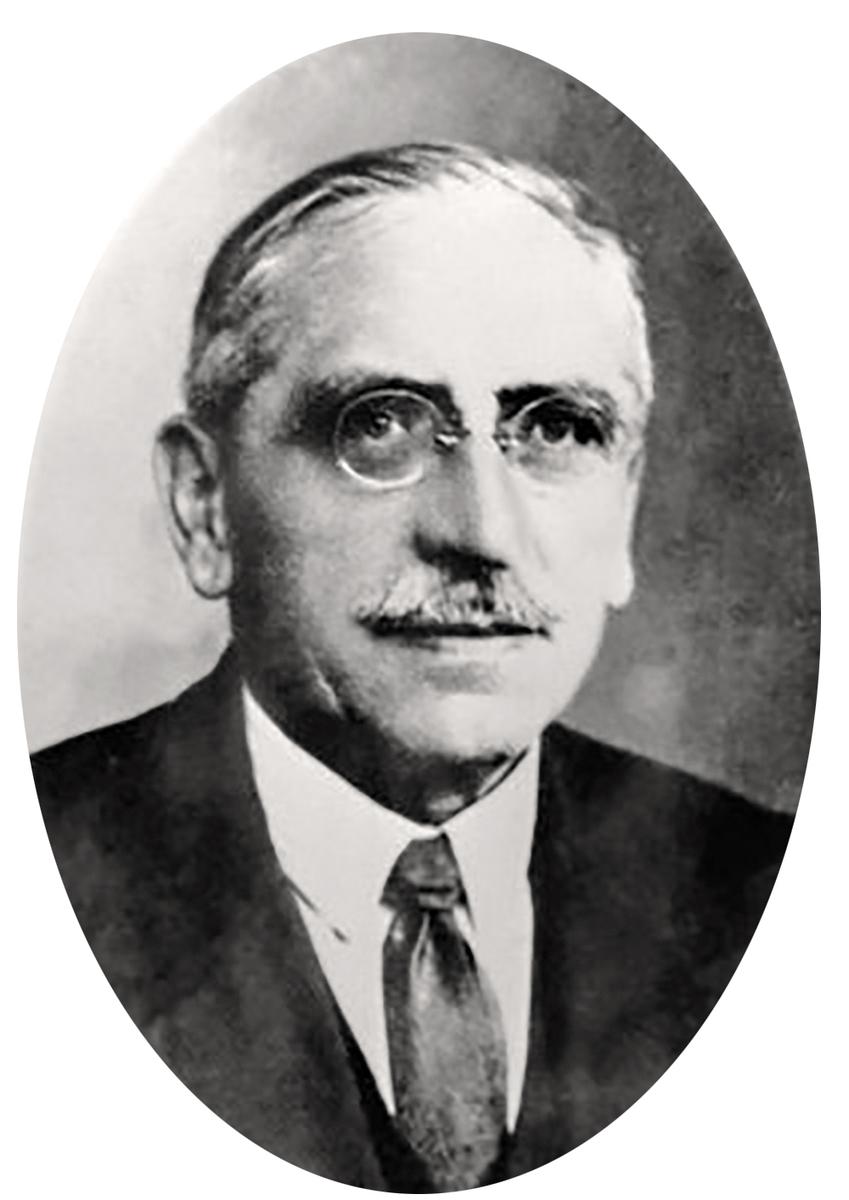
Henri Lebesgue(1875—1941)
法国数学家。
1901年,Lebesgue 发表关于积分推广的短文;1902年,他在博士论文 Intégrale, longueur, aire(《积分、长度、面积》)中系统发展了新的测度与积分方法。
Lebesgue 的突破,不只是让某些原本不能积分的函数变得可以积分。
Riemann 的方法可以理解为:
先把定义域切成小块,再研究每一块上的函数值。
但 Lebesgue 积分允许我们反过来组织问题:
先考虑函数能够取哪些值,再研究具有这些值的点构成多大的集合。
设一个函数 f 只取三个不同的值:
f(x)=
\begin{cases}
1,&x\in A_1,\\
3,&x\in A_2,\\
5,&x\in A_3,
\end{cases}
其中
[0,1]=A_1\sqcup A_2\sqcup A_3.假设这些集合都可测。
那么,与其把横轴划分成越来越多的小区间,不如直接问:
函数值等于1的地方有多大?
等于3的地方有多大?
等于5的地方有多大?
于是我们自然得到
\boxed{
\int f\,dm
=
1\cdot m(A_1)
+3\cdot m(A_2)
+5\cdot m(A_3).
}
这不就是我们最初的加权平均吗?
只不过权重不再是三个离散结果的概率,而是每一个函数值对应的集合的测度。
现在重新看 Dirichlet 函数。
f=\mathbf1_{\mathbb Q\cap[0,1]}.它只取两个数值:
0,\qquad1.取值为1的集合是
\mathbb Q\cap[0,1],其 Lebesgue 测度为0。
取值为0的集合是无理数部分,测度为1。
因此:
\begin{aligned}
\int_0^1f\,dm
&=
1\cdot m(\mathbb Q\cap[0,1])\\
&\quad+
0\cdot m([0,1]\setminus\mathbb Q)\\
&=0.
\end{aligned}
问题解决了。
这里存在一个微妙的区别。
我们并没有改变函数本身。
也没有设法把它变得连续。
我们改变的是衡量与累加函数值的方法。
当一个函数在定义域中极其不规则地跳动时,它仍然可能在测度意义下具有非常简单的结构。
这就是 Lebesgue 积分最重要的思想转变之一。
但到目前为止,我们只处理了取有限多个值的函数。
真正的困难是:
如果一个函数取无限多个值,我们应该怎么办?
6.4 从最简单的函数开始:积分其实是一种带权求和
在第五章中,我们曾经发现一个重要的方法。
当我们无法直接测量任意复杂集合时,可以先从区间出发,再通过适当的极限过程扩展到更一般的集合。
现在,我们对函数采用类似的方法。
不要一开始就试图积分任意复杂的可测函数。
先研究最简单的函数,再逐步扩大积分的适用范围。
6.4.1 简单函数的诞生
设 (\Omega,\mathcal F,\mu) 是一个测度空间。
考虑函数
s:\Omega\to[0,\infty)并假设它只取有限多个不同的值:
a_1,\ldots,a_m.如果每一个集合
A_i=\{\omega:s(\omega)=a_i\}都可测,那么我们可以写成
\boxed{
s=\sum_{i=1}^ma_i\mathbf1_{A_i}.
}
这样的函数称为非负简单函数(nonnegative simple function)。
注意,这并没有要求 A_i 是区间。
它们可以是复杂的 Borel 集、Cantor 集的可测子集,或者一般概率空间中的事件。
因为这些集合两两不相交,我们可以自然定义:
\boxed{
\int_\Omega s\,d\mu
=
\sum_{i=1}^ma_i\mu(A_i).
}
其中若 a_i=0,对应项规定为0,即使 \mu(A_i)=\infty。
这就是简单函数的积分。
如果 \mu=P 是概率测度,那么它恰好回到了第一章的期望公式:
\mathbb E[s]
=
\sum_{i=1}^ma_iP(A_i).
我们可以看到:
Lebesgue 积分首先并不是一种全新的运算,而是把有限的加权求和推广到了可测集合上的运算。
它保留了我们此前所有关于期望的基本直觉。
例如,对于非负简单函数 s,t 和常数 a,b\ge0,
\int(as+bt)\,d\mu
=
a\int s\,d\mu+b\int t\,d\mu.
为什么?
因为我们可以利用 s,t 的各个取值集合,构造一个共同的有限可测划分。
在划分的每一块上,两个函数都是常数,因此上面的等式只是有限求和的分配律和测度的有限可加性。
同样,如果
0\le s\le t,那么
\int s\,d\mu\le\int t\,d\mu.这些性质对于简单函数都十分自然。
真正的问题,是如何从简单函数走向一般可测函数。
6.4.2 为什么任何非负可测函数都能够用简单函数逼近?
假设
f:\Omega\to[0,\infty]是非负可测函数。
我们希望找到一列简单函数
s_1,s_2,\ldots满足
0\le s_1\le s_2\le\cdots且
s_n(\omega)\uparrow f(\omega)对所有 \omega 成立。
能否做到?
一个自然的想法是,把函数值轴划分成越来越细的小区间。
例如,第一次用长度为 1/2 的区间划分。
第二次用长度为 1/4 的区间划分。
第 n 次用长度为 2^{-n} 的区间划分。
然后把每个函数值向下取到最近的网格点。
为了确保每一步只取有限多个值,再把函数值截断在 n 以下。
定义
\boxed{
s_n(\omega)
=
2^{-n}\left\lfloor
2^n\min\{f(\omega),n\}
\right\rfloor.
}
这里允许 f(\omega)=\infty。
这个表达式虽然看起来复杂,但其含义很简单:
首先,不考虑超过 n 的函数值。
然后,以 2^{-n} 为精度,从下方近似剩余部分。
对于每个 n,s_n 只取有限多个值,因此是简单函数。
由于 f 可测,每一个取值集合也可测。
而且,随着 n 增加,截断上限变大、网格精度变细,所以
s_n\le s_{n+1}.最后,
\boxed{s_n(\omega)\uparrow f(\omega).}我们由此得到一个重要的构造定理:
任何非负可测函数,都可以由一列单调递增的非负简单函数逐点逼近。
这一步是整个 Lebesgue 积分理论的基础之一。
它告诉我们,即使 f 的取值和变化极其复杂,我们仍然能够用有限加权求和的方式逐步逼近它。
6.4.3 既然能够逼近,为什么不直接定义积分?
现在,我们已经知道如何积分简单函数。
并且任何非负可测函数都可以由简单函数从下方逼近。
因此,一种十分自然的想法出现了:
把所有位于 f 下方的简单函数积分值收集起来,再取它们的上确界。
于是定义
\boxed{
\int_\Omega f\,d\mu
=
\sup\left\{
\int_\Omega s\,d\mu:
0\le s\le f,\ s\text{ 为简单函数}
\right\}.
}
这就是非负可测函数的 Lebesgue 积分。
此时积分值可能为 +\infty。
但这不是定义的缺陷。
它是理论有意允许的结果。
我们暂时不要求所有随机变量都有有限期望,因为那将迫使我们排除许多自然的概率模型。
现在,请重新审视这个定义。
它把我们熟悉的有限加权和:
\sum_{i=1}^ma_i\mu(A_i)推广到一般可测函数:
\int f\,d\mu.而且没有使用函数的连续性,也没有要求函数具有密度,更没有要求 \Omega 是一个实数区间。
这使得它能够处理随机变量、随机函数,甚至更加抽象空间上的可测对象。
但现在,真正重要的困难出现了。
我们知道 s_n\uparrow f。
是否就能够断言:
\int s_n\,d\mu\longrightarrow\int f\,d\mu?如果答案是肯定的,那么我们通过简单函数逼近一般函数的整个思路才真正成立。
这就是单调收敛定理所解决的问题。
6.5 Beppo Levi:为什么从下方逼近不会丢失积分?
Beppo Levi(1875—1961)
意大利数学家。他在1906年证明的重要收敛结果,今天通常称为 Beppo Levi 定理或单调收敛定理。
这里有一个值得注意的历史细节。
在今天的测度论教材中,我们常常按照“单调收敛定理、Fatou 引理、控制收敛定理”的顺序学习。
但历史发展的顺序并不完全如此。Lebesgue 的1902年论文已经包含有界收敛思想,而 Beppo Levi 与 Fatou 在1906年分别作出重要贡献;控制收敛定理的更一般形式则在 Lebesgue 后续工作中得到发展。〔57〕
我们继续沿着数学上的自然问题研究。
定理 6.1:单调收敛定理
校订补注:本定理还约定极限函数
f非负且可测;在非完备空间中,几乎处处收敛应取可测极限版本。见附录 E。 从简单函数定义出发、不预用一般线性性的证明见单调收敛补证。
设 f_1,f_2,\ldots 是非负可测函数,满足
0\le f_1\le f_2\le\cdots并且
f_n(\omega)\uparrow f(\omega)几乎处处成立。
那么
\boxed{
\lim_{n\to\infty}
\int_\Omega f_n\,d\mu
=
\int_\Omega f\,d\mu.
}
这里允许两侧等于 +\infty。
这个定理非常强大。
它不要求 \mu(\Omega) 有限。
不要求各个 f_n 有统一上界。
甚至不要求它们的积分有限。
它只要求非负性和单调递增。
为什么这两个条件如此有效?
6.5.1 证明:先理解容易的方向
因为
f_n\le f,所以由积分的单调性,
\int f_n\,d\mu\le\int f\,d\mu.因此
\lim_{n\to\infty}\int f_n\,d\mu
\le
\int f\,d\mu.
这部分毫无困难。
真正的问题在于反方向:
\int f\,d\mu
\le
\lim_{n\to\infty}\int f_n\,d\mu.
我们必须证明:
即使 f_n 始终在 f 下方,它们的积分也不会永久遗漏 f 的某一部分。
6.5.2 证明的关键:与任意简单函数比较
任取非负简单函数 s,满足
s\le f.我们希望证明
\int s\,d\mu
\le
\lim_{n\to\infty}\int f_n\,d\mu.
如果能对所有这样的 s 成立,再对 s 取上确界,便得到结论。
但我们不能直接断言对某个足够大的 n,必然有 f_n\ge s。
因为 f_n 可能一直从下方逐渐接近 f,从未完全达到 s=f 的部分。
为了绕开这个问题,我们引入一个略小的比例。
任取
0<c<1.定义
A_n=\{\omega:f_n(\omega)\ge c\,s(\omega)\}.因为 f_n\uparrow f,且 s\le f,可以证明
A_n\uparrow\Omega在逐点收敛成立的集合上。
确实,如果 s(\omega)>0,那么
f(\omega)\ge s(\omega)>c\,s(\omega),因此当 n 足够大时,
f_n(\omega)\ge c\,s(\omega).如果 s(\omega)=0,则因 f_n\ge0,这个不等式对所有 n 都成立。
于是
f_n\ge c\,s\mathbf1_{A_n}.由积分的单调性,
\int f_n\,d\mu
\ge
c\int s\mathbf1_{A_n}\,d\mu.
由于 s 是简单函数,可以写成
s=\sum_{j=1}^ma_j\mathbf1_{E_j}.所以
\int s\mathbf1_{A_n}\,d\mu
=
\sum_{j=1}^ma_j\mu(E_j\cap A_n).
因为
E_j\cap A_n\uparrow E_j在排除一个零测集后成立,而第五章已经证明了测度对递增集合序列的连续性,所以
\mu(E_j\cap A_n)\uparrow\mu(E_j).因此
\lim_{n\to\infty}
\int s\mathbf1_{A_n}\,d\mu
=
\int s\,d\mu.
于是
\lim_{n\to\infty}\int f_n\,d\mu
\ge c\int s\,d\mu.
令 c\uparrow1,得到
\lim_{n\to\infty}\int f_n\,d\mu
\ge\int s\,d\mu.
这对所有满足 0\le s\le f 的简单函数成立。
所以取上确界:
\lim_{n\to\infty}\int f_n\,d\mu
\ge
\sup_{0\le s\le f}
\int s\,d\mu
=
\int f\,d\mu.
结合前一个方向,
\boxed{
\int f_n\,d\mu\uparrow\int f\,d\mu.
}
证毕。
6.5.3 这个定理真正揭示了什么?
我认为这里最值得记住的,不是证明中的那个辅助集合 A_n。
而是一个更深层的原则:
非负函数的积分可以通过不断增加已知信息、不断改善下方近似来恢复,而且不会遗漏任何正的测度贡献。
我们在第五章中已经看到,概率测度具有
A_n\uparrow A
\implies P(A_n)\uparrow P(A).
现在,在第六章中,我们发现对应的函数层面结论:
f_n\uparrow f
\implies
\int f_n\,dP\uparrow\int f\,dP.
两者之间存在非常自然的联系。
实际上,如果选择
f_n=\mathbf1_{A_n},那么
\int f_n\,dP=P(A_n).因此,测度的下连续性可以看作单调收敛定理在指示函数上的特殊形式。
反过来,单调收敛定理又是将这种集合层面的连续性推广到一般非负可测函数。
这正是我们一直在寻找的统一:
\boxed{
\text{集合的极限}
\quad\longrightarrow\quad
\text{函数的极限}
}
概率与积分不再是两套彼此无关的理论。
积分是测度思想在函数层面上的自然延伸。
6.6 一个新的困难:不是所有随机变量都拥有有限期望
到目前为止,我们只讨论了非负可测函数。
但是,赌博中的收益可以为负。
真实世界中的随机变量也可能同时取正值和负值。
那么,应该怎样定义它们的积分?
最自然的办法,是将一个实值函数分解成正、负两部分。
定义
f^+=\max\{f,0\},f^-=\max\{-f,0\}.于是
f=f^+-f^-,并且
|f|=f^++f^-.因为 f^+,f^- 都是非负可测函数,我们已经知道怎样定义它们的积分。
所以尝试定义
\boxed{
\int f\,d\mu
=
\int f^+\,d\mu-\int f^-\,d\mu.
}
但这里出现了一个问题。
假如
\int f^+\,d\mu=\infty,
\qquad
\int f^-\,d\mu=\infty,
那么我们得到的是
\infty-\infty.这个表达式并没有明确的数学意义。
因此,我们至少要求两个积分中有一个是有限的,才能将其差定义成扩展实数意义下的积分。
如果进一步要求
\int|f|\,d\mu<\infty,那么 f^+,f^- 的积分都有限。
我们就说 f 是可积的(integrable)。
在概率空间中,这对应
\boxed{
\mathbb E[|X|]<\infty.
}
它保证 \mathbb E[X] 是一个有限实数。
6.6.1 一场所有收益都有限、期望却是无穷大的赌博
考虑一场新的赌博。
玩家投掷某种装置,获得随机收益 X。
假设
P(X=2^n)=2^{-n},
\qquad n=1,2,\ldots.
这是一个合法的概率分布,因为
\sum_{n=1}^{\infty}2^{-n}=1.而且,X 在每一次实际实验中都取某个有限数值。
也就是说,
P(X<\infty)=1.但我们计算它的期望:
\begin{aligned}
\mathbb E[X]
&=\sum_{n=1}^{\infty}2^nP(X=2^n)\\
&=\sum_{n=1}^{\infty}2^n2^{-n}\\
&=\sum_{n=1}^{\infty}1\\
&=\infty.
\end{aligned}
因此
\boxed{
X<\infty\text{ a.s.},
\qquad
\mathbb E[X]=\infty.
}
每一次实际游戏都只会支付有限金额,但其理论平均收益却是无穷大。
这与著名的圣彼得堡悖论具有相同的基本结构。
它迫使我们重新区分:
一个随机变量几乎必然有限,与它是否拥有有限期望,是两回事。
更进一步,无穷期望也不意味着一个人应该愿意支付任意高的入场费。现实决策还涉及财富约束、效用、风险和支付能力。
我们第一章使用的“公平价值”,对应的是在特定定价假设下的数学期望。它并不能自动等同于每个人面对风险时的主观价值。
6.6.2 为什么 Cauchy 分布没有期望?
第三章,我们曾经遇到标准 Cauchy 分布:
f(x)=\frac1{\pi(1+x^2)}.由于密度关于原点对称,人们可能直接认为
\mathbb E[X]=0.但这是一个危险的推断。
我们需要分别检查正、负两部分。
对于正部,
\begin{aligned}
\mathbb E[X^+]
&=\int_0^\infty\frac{x}{\pi(1+x^2)}\,dx\\
&=\frac1{2\pi}
\lim_{R\to\infty}\log(1+R^2)\\
&=\infty.
\end{aligned}
由对称性,
\mathbb E[X^-]=\infty.所以
\mathbb E[X]
=
\mathbb E[X^+]-\mathbb E[X^-]
没有定义。
虽然对称截断积分满足
\lim_{R\to\infty}
\int_{-R}^{R}\frac{x}{\pi(1+x^2)}\,dx=0,
但这只是 Cauchy 主值式的对称截断结果,并不是 Lebesgue 意义下的期望。
我们由此认识到:
积分理论不仅告诉我们怎样计算平均,也必须告诉我们什么时候平均根本不存在。
这正是严格定义的价值。
6.7 极限与期望为什么不能随意交换?
现在,我们终于具备条件,研究本章最重要的另一类问题。
假设我们有一列随机变量
X_1,X_2,\ldots并且
X_n\longrightarrow X几乎处处成立。
我们是否可以直接得出
\mathbb E[X_n]\longrightarrow\mathbb E[X]?这看起来十分合理。
既然随机变量的值正在收敛,为什么它们的平均不应该一起收敛?
但事实远没有这么简单。
6.7.1 一个越来越窄、越来越高的尖峰
在区间 [0,1] 上取 Lebesgue 测度,定义
f_n(x)=n\mathbf1_{(0,1/n)}(x).这个函数只有两个取值:
f_n(x)=
\begin{cases}
n,&0<x<1/n,\\
0,&\text{其他位置}.
\end{cases}
随着 n 增加,函数的非零区域越来越窄,但高度越来越大。
收缩尖峰实验:f_n=n\mathbf1_{(0,1/n)}。非零区间宽度为 1/n,积分值为 1。纵轴随所选 n 使用固定比例尺。尖峰越来越窄,但面积始终保持1。
对于任意固定的 x\in[0,1],最终都有
f_n(x)=0.所以
\boxed{f_n(x)\longrightarrow0}在每个点都成立。
然而,
\begin{aligned}
\int_0^1f_n(x)\,dx
&=
n\cdot\frac1n\\
&=1.
\end{aligned}
因此
\boxed{
\lim_{n\to\infty}\int_0^1f_n(x)\,dx
=1
\ne
0
=
\int_0^1\lim_{n\to\infty}f_n(x)\,dx.
}
这里甚至不需要研究复杂的概率分布。
一列非常简单的非负函数,就已经说明:逐点收敛并不能保证积分收敛。
究竟发生了什么?
随着 n 增加,函数的全部积分贡献都集中到了越来越小的区域。
对于任何固定的点,这个尖峰最终都会离开它。
所以逐点极限看不到这些积分贡献。
但每一次尖峰的总面积仍然等于1。
我们可以把它称为一种质量集中现象。
还有另一种类似的失败机制。
在整个实数轴上,考虑
g_n(x)=\mathbf1_{(n,n+1)}(x).同样有
g_n(x)\to0对每个固定的 x 成立。
但
\int_{\mathbb R}g_n(x)\,dx=1.这里质量没有集中到一个越来越小的区间。
它只是不断向无穷远处移动。
这可以称为质量逃逸现象。
因此,我们已经认识了两种积分极限可能失败的原因:
局部质量过度集中,以及质量向空间无穷远处逃逸。
现在我们需要一种定理,能够在不要求积分与极限完全交换的情况下,至少提供某种普遍成立的估计。
这就是 Fatou 引理。
6.8 Fatou 引理:即使不能交换极限,我们仍然能够保留什么?
定理 6.2:Fatou 引理
设 f_1,f_2,\ldots 是非负可测函数。
那么
\boxed{
\int_\Omega\liminf_{n\to\infty}f_n\,d\mu
\le
\liminf_{n\to\infty}\int_\Omega f_n\,d\mu.
}
这里我们不要求 f_n 单调。
甚至不要求 f_n 本身存在逐点极限。
我们只使用下极限:
\liminf_{n\to\infty}f_n.这个定理可以理解为:
在非负函数的极限过程中,积分贡献可能消失,但下极限函数的积分不能超过原积分序列的下极限。
刚才的尖峰例子恰好体现了这种不等式可能严格成立:
0<1.6.8.1 为什么 Fatou 引理能够由单调收敛定理推出?
定义
h_n(\omega)=\inf_{k\ge n}f_k(\omega).由于我们每次取下确界的集合越来越小,
h_1\le h_2\le\cdots.而且
h_n\uparrow\liminf_{n\to\infty}f_n.所以我们可以使用单调收敛定理:
\int\liminf_{n\to\infty}f_n\,d\mu
=
\lim_{n\to\infty}\int h_n\,d\mu.
另一方面,对所有 k\ge n,
h_n\le f_k.所以
\int h_n\,d\mu
\le
\inf_{k\ge n}\int f_k\,d\mu.
让 n\to\infty,便得到
\begin{aligned}
\int\liminf_{n\to\infty}f_n\,d\mu
&=
\lim_n\int h_n\,d\mu\\
&\le
\lim_n\inf_{k\ge n}\int f_k\,d\mu\\
&=
\liminf_{n\to\infty}\int f_n\,d\mu.
\end{aligned}
证毕。
这段证明展示了测度论中一种非常重要的策略。
当原序列没有单调性时,我们可以通过取尾部下确界,构造一个单调递增的新序列。
于是,单调收敛定理便能够解决原本并不单调的问题。
Fatou 引理并不是一种完全独立于单调收敛定理的神奇规则。
它可以从单调收敛这一基础结构中自然发展出来。
但 Fatou 引理仍然只给出了单侧不等式。
如果我们想要真正交换积分与极限,就需要控制那个可能集中或逃逸的积分贡献。
这将带领我们走向 Lebesgue 积分中最常用的定理之一。
6.9 控制收敛定理:什么条件能够阻止积分质量消失?
重新看刚才的反例:
f_n(x)=n\mathbf1_{(0,1/n)}(x).问题在于,函数虽然只在很小的区域内非零,但高度却随着 n 增加而变得任意大。
如果我们能够找到一个固定的、可积的函数 g,并且所有 f_n 都满足
|f_n|\le g,那么这种失控是否就能够避免?
事实上,这正是控制收敛定理的核心。
定理 6.3:Lebesgue 控制收敛定理
校订补注:以下极限函数
f取为可测函数;实值或复值函数均可,证明按相应分量理解。见附录 E。 DCT 对任意测度空间成立;非负线性性、共同零集及完整证明见积分基础。
设 f_n 是一列可测函数,并且
f_n\longrightarrow f
\qquad\mu\text{-a.e.}
假设存在一个非负可积函数 g,使得
|f_n|\le g
\qquad\mu\text{-a.e.}
对所有 n 成立。
那么 f 可积,并且
\boxed{
\lim_{n\to\infty}\int f_n\,d\mu
=
\int f\,d\mu.
}
事实上,我们还能得到更强的结论:
\boxed{
\int|f_n-f|\,d\mu\longrightarrow0.
}
第二个结论说明,控制收敛实际上可以产生 L^1 收敛,而不只是积分数值的收敛。
这将在我们系统研究各种随机收敛时变得重要。
6.9.1 为什么一个可积的上界如此有效?
如果
|f_n|\le g并且
\int g\,d\mu<\infty,那么对于每一个可测集合 A,
\int_A|f_n|\,d\mu
\le
\int_Ag\,d\mu.
由于 g 可积,积分具有绝对连续性:
对于任意 \varepsilon>0,存在 \delta>0,使得
\mu(A)<\delta
\implies
\int_Ag\,d\mu<\varepsilon.
于是,无论 n 多大,f_n 都不可能在一个测度任意小的区域内保留固定大小的积分贡献。
同样,对于可积控制函数 g,也可以控制其尾部贡献;在一般测度空间中,有限测度集合可穷尽的是有效支集 \{g>0\},不必能穷尽整个空间。DCT 本身不要求 σ-有限性,准确论证见控制函数的有效支集。
因此,一个固定的可积上界,恰好排除了前面两个反例中那些无法控制的积分质量。
这解释了控制收敛定理为什么需要的是一个可积的控制函数,而不只是函数值存在某种上界。
例如,在无限测度空间上,
|f_n|\le1并不一定足够。
刚才的
g_n=\mathbf1_{(n,n+1)}就全部满足 |g_n|\le1,却仍然不能交换极限与积分,因为常数函数1在整个实数轴上不可积。
6.9.2 控制收敛定理的严格证明
现在我们已经有 Fatou 引理,证明反而十分简洁。
由于
|f_n|\le g且 f_n\to f 几乎处处,
|f|\le g几乎处处成立。
因此 f 可积。
同时,
g+f_n\ge0,
\qquad
g-f_n\ge0.
首先,对非负函数 g+f_n 使用 Fatou 引理:
\int(g+f)\,d\mu
\le
\liminf_{n\to\infty}
\int(g+f_n)\,d\mu.
因为 g 可积,我们可以合法地减去 \int g\,d\mu,得到
\boxed{
\int f\,d\mu
\le
\liminf_{n\to\infty}\int f_n\,d\mu.
}
再对 g-f_n 使用 Fatou 引理:
\int(g-f)\,d\mu
\le
\liminf_{n\to\infty}\int(g-f_n)\,d\mu.
因此
\int g\,d\mu-\int f\,d\mu
\le
\int g\,d\mu-
\limsup_{n\to\infty}\int f_n\,d\mu.
整理得到
\boxed{
\limsup_{n\to\infty}\int f_n\,d\mu
\le
\int f\,d\mu.
}
结合两个不等式:
\int f\,d\mu
\le
\liminf_n\int f_n\,d\mu
\le
\limsup_n\int f_n\,d\mu
\le
\int f\,d\mu.
所以
\boxed{
\lim_{n\to\infty}\int f_n\,d\mu
=
\int f\,d\mu.
}
最后,因为
|f_n-f|\longrightarrow0几乎处处,并且
|f_n-f|\le2g,对新的非负函数序列 |f_n-f| 再应用刚才证明的积分收敛结论,便得到
\boxed{
\int|f_n-f|\,d\mu\longrightarrow0.
}
证毕。
6.9.3 三个收敛定理之间的关系
现在回顾我们刚才建立的三个结果。
| 定理 | 核心条件 | 结论 |
|---|---|---|
| 单调收敛 | 0\le f_n\uparrow f |
积分与极限可以交换,允许无穷积分 |
| Fatou 引理 | f_n\ge0 |
得到关于下极限的单侧不等式 |
| 控制收敛 | f_n\to f a.e.,|f_n|\le g\in L^1 |
积分可交换,且 f_n\to f 于 L^1 |
我们看到,这三条定理并不是彼此孤立的知识点。
它们都在回答同一个问题:
\boxed{
\text{什么时候可以将极限移入积分?}
}
只是对于不同的函数序列,我们拥有不同程度的信息。
如果函数单调增加,那么我们可以利用非负积分从下方逼近的结构。
如果函数不单调,但仍然非负,那么至少可以利用 Fatou 引理获得下界。
如果函数拥有一个统一的可积控制,那么可以进一步得到完整的收敛结论。
这是一套逐渐精细化的数学语言。
值得一提的是,我们习惯的这套证明顺序主要体现现代数学的逻辑组织,而非历史发现顺序。Beppo Levi、Fatou、Lebesgue 和 Vitali 在二十世纪初围绕积分极限作出了相互关联的贡献。〔57〕
6.10 为什么积分能够统一所有随机变量的分布?
到这里,我们已经严格建立了 Lebesgue 积分。
现在,我们可以返回概率论,并解决一个此前反复出现的问题。
假设
X:(\Omega,\mathcal F,P)\to(\mathbb R,\mathcal B(\mathbb R))是一个随机变量。
我们希望计算
\mathbb E[h(X)]其中 h:\mathbb R\to\mathbb R 是 Borel 可测函数。
是否必须知道 X 在原样本空间中如何构造?
不一定。
事实上,只要知道 X 的分布,就足以计算所有相应的可积函数的期望。
6.10.1 从简单函数开始证明
回忆第五章:
P_X(B)=P(X^{-1}(B)).现在先考虑一个简单函数:
h=\sum_{i=1}^ma_i\mathbf1_{B_i},其中 B_i 是 Borel 集。
那么
h(X)
=
\sum_{i=1}^ma_i\mathbf1_{\{X\in B_i\}}.
所以
\begin{aligned}
\mathbb E[h(X)]
&=\sum_{i=1}^ma_iP(X\in B_i)\\
&=\sum_{i=1}^ma_iP_X(B_i)\\
&=\int_{\mathbb R}h(x)\,P_X(dx).
\end{aligned}
对于非负 Borel 可测函数 h,我们可以选择简单函数序列
h_n\uparrow h.然后对两侧应用单调收敛定理,得到
\boxed{
\mathbb E[h(X)]
=
\int_{\mathbb R}h(x)\,P_X(dx).
}
对于一般的可积 h(X),再通过正、负部分即可推广。
这就是常被称为 law of the unconscious statistician 的积分公式,本质上也是推前测度的积分变换公式。
它告诉我们:
如果只想计算一个随机变量的分布函数型期望,我们不必了解它背后整个概率空间的具体构造。
只需要知道它的分布测度 P_X。
这是一种非常强的抽象能力。
6.10.2 离散分布与连续分布只不过是特殊情况
如果 X 是离散随机变量,取值为 x_i,对应权重为 p_i,那么
P_X=\sum_i p_i\delta_{x_i}.这里 \delta_{x_i} 是集中在 x_i 的 Dirac 测度。
因此
\int h(x)\,P_X(dx)
=
\sum_i h(x_i)p_i.
我们回到了加权求和。
如果 X 的分布相对于 Lebesgue 测度具有密度 f_X,那么
P_X(dx)=f_X(x)\,dx.所以
\int h(x)\,P_X(dx)
=
\int_{\mathbb R}h(x)f_X(x)\,dx.
我们又回到了连续型随机变量的熟悉公式。
但是,现在考虑一个更加特殊的随机变量。
假设 X 具有 Cantor 分布。
它的分布函数是连续的,且没有任何单点原子,但其分布集中在 Lebesgue 测度为零的 Cantor 集上。
因此它不是离散分布,也没有相对于 Lebesgue 测度的概率密度。
然而
\boxed{
\mathbb E[h(X)]
=
\int_{\mathbb R}h(x)\,P_X(dx)
}
仍然完全合法。
我们终于理解了为什么现代概率论不应该把期望定义成
\sum_xxf(x)或者
\int xf(x)\,dx.因为这些只对应特殊类型的分布。
真正一般的形式是
\boxed{
\mathbb E[X]
=
\int_\Omega X\,dP
=
\int_{\mathbb R}x\,P_X(dx),
}
前提是相应积分有定义。
这与我们整本书的思想完全一致。
我们并不是发明一种与旧方法无关的新理论。
而是找到了一个更大的数学结构,使旧方法成为它的特殊情况。
6.11 一个意外的公式:期望也可以通过尾部概率来计算
我们已经知道非负随机变量的期望是
\mathbb E[X]=\int_\Omega X\,dP.但是,如果我们不直接知道 X 的密度,只知道它的尾部概率
P(X>t),能否仍然计算期望?
对于非负实数 x,有一个简单的恒等式:
\boxed{
x=\int_0^\infty\mathbf1_{\{x>t\}}\,dt.
}
为什么?
因为当 x\ge0 时,
\mathbf1_{\{x>t\}}
=
\begin{cases}
1,&0\le t<x,\\
0,&t\ge x.
\end{cases}
所以右侧只是长度为 x 的区间的长度。
将 x 替换为非负随机变量 X(\omega),得到
X(\omega)
=
\int_0^\infty\mathbf1_{\{X(\omega)>t\}}\,dt.
于是
\mathbb E[X]
=
\int_\Omega
\left(
\int_0^\infty
\mathbf1_{\{X(\omega)>t\}}\,dt
\right)P(d\omega).
如果我们可以交换这两个积分的次序,那么
\begin{aligned}
\mathbb E[X]
&=
\int_0^\infty
\left(
\int_\Omega
\mathbf1_{\{X(\omega)>t\}}P(d\omega)
\right)dt\\
&=
\int_0^\infty P(X>t)\,dt.
\end{aligned}
于是
\boxed{
\mathbb E[X]
=
\int_0^\infty P(X>t)\,dt.
}
这个公式有时称为 tail integral formula,或者 layer-cake representation。
它揭示了期望的另一种解释:
非负随机变量的期望,可以理解为其所有尾部事件概率的累积。
例如,假设
P(X>t)=e^{-\lambda t},
\qquad t\ge0.
那么
\mathbb E[X]
=
\int_0^\infty e^{-\lambda t}\,dt
=
\frac1\lambda.
我们并没有首先使用概率密度,而是直接从尾部概率得到了期望。
这在研究重尾分布时尤其重要。
如果对于足够大的 t,
P(X>t)\asymp t^{-\alpha},那么尾部积分
\int_1^\infty t^{-\alpha}\,dt当且仅当 \alpha>1 时有限。
因此,尾部衰减的速度直接决定期望是否有限。
但我们刚才的推导留下了一个问题:
为什么可以交换两个积分?
这将引导我们进入本章最后一个重要的定理。
6.12 Fubini–Tonelli:什么时候可以改变求和与积分的顺序?
校订补注:乘积集合截面、单调类步骤及乘积测度构造的展开证明见附录 C。 其中的 π–λ、集合及函数单调类定理已在生成类补证中完整证明。
回想第一章。
在有限概率空间中,我们可以随意改变有限求和的顺序:
\sum_{i=1}^m\sum_{j=1}^na_{ij}
=
\sum_{j=1}^n\sum_{i=1}^ma_{ij}.
这是一个再普通不过的代数性质。
但是,当我们研究无限多个随机结果时,求和与积分的顺序是否仍然可以随意交换?
考虑一个二元随机系统,结果空间为
\Omega_1\times\Omega_2.我们希望计算一个函数
f:\Omega_1\times\Omega_2\to\mathbb R的积分。
我们可以先对第二个变量积分,再对第一个变量积分。
也可以反过来。
问题在于:
\boxed{
\int_{\Omega_1}
\left(
\int_{\Omega_2}f(x,y)\,\nu(dy)
\right)\mu(dx)
\overset{?}{=}
\int_{\Omega_2}
\left(
\int_{\Omega_1}f(x,y)\,\mu(dx)
\right)\nu(dy).
}
在一般情况下,这两个表达式真的相等吗?
为了回答,我们首先需要理解乘积测度。
6.12.1 如何为两个空间的联合结果赋予测度?
假设
(\Omega_1,\mathcal F_1,\mu)和
(\Omega_2,\mathcal F_2,\nu)是两个测度空间。
对于矩形集合
A\times B,最自然的定义是
(\mu\times\nu)(A\times B)=\mu(A)\nu(B).当 \mu,\nu 是概率测度时,这正好与独立事件的乘法规则相对应。
但仅仅定义矩形的测度还不够。
因为联合空间中存在大量不能写成单个矩形的集合。
因此,我们需要在由可测矩形生成的 \sigma-代数
\mathcal F_1\otimes\mathcal F_2
=
\sigma\{A\times B:A\in\mathcal F_1,B\in\mathcal F_2\}
上构造测度。
在 \sigma-有限的条件下,可以利用测度扩张理论建立具有所需矩形测度的唯一乘积测度。
这件事又一次说明,第五章的测度扩张理论绝不是一个孤立的技术问题。
它使我们能够从单个随机实验,严格构造多个随机实验组成的联合空间。
6.12.2 Tonelli 定理:对于非负函数,交换顺序总是安全的
现在假设
f:\Omega_1\times\Omega_2\to[0,\infty]是乘积可测的非负函数,且两个测度空间 \sigma-有限。
Tonelli 定理告诉我们:
\boxed{
\begin{aligned}
\int_{\Omega_1\times\Omega_2}f\,d(\mu\times\nu)
&=
\int_{\Omega_1}
\left(\int_{\Omega_2}f(x,y)\,\nu(dy)\right)\mu(dx)\\
&=
\int_{\Omega_2}
\left(\int_{\Omega_1}f(x,y)\,\mu(dx)\right)\nu(dy).
\end{aligned}
}
这里允许积分等于 +\infty。
我们先来理解为什么它成立。
对于矩形的指示函数
f=\mathbf1_{A\times B},结论只是
(\mu\times\nu)(A\times B)=\mu(A)\nu(B).对于非负简单函数,则由线性性得到对应公式。
为了把结论推广到一般非负可测函数,还需要一个关于乘积可测集合及其截面可测性的步骤。可以先从矩形集合出发,利用单调类论证将相应积分恒等式扩展到乘积 \sigma-代数中的集合,再推广到简单函数。
最后,对任意非负可测函数 f,选择简单函数
s_n\uparrow f,并对有关积分逐层应用单调收敛定理。
这就得到 Tonelli 公式。
注意其中的结构。
矩形集合上的测度乘法关系,是最初的出发点。
简单函数使它变成有限加权求和。
单调收敛定理则把有限结构推广到了任意非负可测函数。
Tonelli 定理又一次显示,Lebesgue 积分的力量来自简单对象、测度的可加性与极限运算之间的协作。
我们在6.11节得到的尾部积分公式,现在也获得了严格依据。
因为
(\omega,t)\longmapsto
\mathbf1_{\{X(\omega)>t\}}
是非负且乘积可测的函数,所以 Tonelli 定理允许我们交换两个积分,而不需要预先知道 \mathbb E[X] 有限。
6.12.3 Fubini 定理:有正有负时,我们需要更多条件
但对于一般的实值函数,情况不同。
如果正负贡献无限交错,那么改变积分顺序可能改变结果,甚至使某个积分无法定义。
为了理解这种危险,我们先看一个完全离散的例子。
定义双指标数列
a_{mn}=
\begin{cases}
1,&n=m,\\
-1,&n=m+1,\\
0,&\text{其他情况},
\end{cases}
\qquad m,n\ge1.
对于每个固定的 m,这一行恰好有一个 1 和一个 -1。
所以
\sum_{n=1}^{\infty}a_{mn}=0.因此
\boxed{
\sum_{m=1}^{\infty}
\left(\sum_{n=1}^{\infty}a_{mn}\right)=0.
}
但是,如果先对 m 求和:
第一列只有一个 1,所以列和为1。
而对于第 n\ge2 列,恰好有一个 1 和一个 -1,列和为0。
于是
\boxed{
\sum_{n=1}^{\infty}
\left(\sum_{m=1}^{\infty}a_{mn}\right)=1.
}
我们竟然得到了两个不同的答案!
为什么?
因为
\sum_{m,n}|a_{mn}|=\infty.正负贡献的总绝对值无法控制。
所以,改变无限求和的顺序可能带来不同结果。
这提醒我们:
有限求和中的交换律,不能未经条件就推广到无限求和或积分。
于是我们需要一个更精确的定理。
定理 6.4:Fubini 定理
设 f 为乘积可测的实值函数,并满足
\boxed{
\int_{\Omega_1\times\Omega_2}
|f|\,d(\mu\times\nu)<\infty.
}
那么相应的迭代积分在适当的几乎处处意义下存在,并满足
\boxed{
\begin{aligned}
\int_{\Omega_1\times\Omega_2}f\,d(\mu\times\nu)
&=
\int_{\Omega_1}
\left(\int_{\Omega_2}f(x,y)\,\nu(dy)\right)\mu(dx)\\
&=
\int_{\Omega_2}
\left(\int_{\Omega_1}f(x,y)\,\mu(dx)\right)\nu(dy).
\end{aligned}
}
证明思想现在非常自然。
将 f 分解为
f=f^+-f^-.因为
f^+,f^-\le|f|,所以它们的积分都有限。
对两个非负函数分别使用 Tonelli 定理,再将结果相减,就得到 Fubini 定理。
这样,我们终于找到了改变积分次序的充分条件。
非负性允许我们使用 Tonelli;绝对可积性则允许我们利用 Fubini 安全地处理正负贡献。
这两个定理将在未来研究联合分布、条件期望、随机积分和随机过程时反复出现。
6.13 从公平价格到概率极限:我们究竟创造了什么?
现在,我们可以重新回到第一章的赌博。
在那里,期望只是一个十分简单的公式:
\mathbb E[X]=\sum_i x_ip_i.但经过本章的研究,我们终于知道,这个公式背后隐藏着一整套可以推广的数学结构。
在有限空间中,我们使用加权求和。
对于简单函数,我们将权重推广为可测集合的测度。
对于一般非负函数,我们利用简单函数的单调逼近来定义积分。
对于有正负值的函数,我们借助正负部分定义可积性。
然后,我们又研究了积分与极限、积分与积分之间的交换条件。
这让我们能够在极其复杂的概率空间中使用同一个表达式:
\boxed{
\mathbb E[X]=\int_\Omega X\,dP.
}
但我认为,这个公式的真正价值,还不只是它统一了离散与连续的期望。
它使很多看起来不同的概率论问题,开始具有同一种逻辑结构。
例如,大数定律研究的是随机平均:
\frac1n\sum_{i=1}^nX_i.我们需要知道这种平均在什么意义下收敛。
统计推断研究的是一列估计量:
\widehat\theta_n.我们需要知道什么时候可以利用极限估计它们的风险:
\mathbb E[(\widehat\theta_n-\theta)^2].随机过程研究的是随时间变化的随机变量:
X_t.我们需要知道什么时候可以交换极限与期望:
\lim_{t\to t_0}\mathbb E[X_t]
\overset{?}{=}
\mathbb E\left[\lim_{t\to t_0}X_t\right].
而我们在第四章中看到的 Brownian motion,也反复需要这样的积分与极限理论。
所以,Lebesgue 积分不仅回答了怎样计算平均值。
它更重要的贡献之一,是提供了一套用于分析极限过程的稳定数学语言。
这与我们最初关于期望的理解形成了一个有趣的对照。
最开始,期望告诉我们怎样衡量尚未发生的随机收益。
如今,期望成为一种定义在抽象函数空间上的积分运算。
它能够处理有限赌博,也能够处理连续随机过程、奇异分布、随机几何与无限维概率模型。
第六章结语:积分不是面积的另一种计算方法
回顾这一章的思想路线。
我们一开始只想把有限加权平均推广到连续空间。
似乎可以直接使用 Riemann 积分。
但 Dirichlet 函数告诉我们,这种积分不能处理某些最基本的随机事件指示函数。
因此,我们不再以定义域的区间划分为唯一出发点,而是从可测函数取值所对应的集合入手。
我们定义简单函数的积分:
\int s\,d\mu=\sum_i a_i\mu(A_i).随后通过下方逼近,将积分推广到一般非负可测函数:
\int f\,d\mu
=
\sup_{0\le s\le f}
\int s\,d\mu.
再通过正负部分,建立一般可积函数的积分。
但是,在处理函数序列时,我们发现了新的困难:
即使
f_n\to f逐点成立,也未必有
\int f_n\,d\mu\to\int f\,d\mu.于是我们需要单调收敛定理、Fatou 引理与控制收敛定理。
当我们想交换两个积分的顺序,又不得不建立 Tonelli 和 Fubini 定理。
这样,一套完整的积分理论逐渐浮现。
有限加权平均
\sum_i a_ip_i简单函数积分
\int\sum_i a_i\mathbf1_{A_i}\,d\mu一般可测函数
\int f\,d\mu=\sup_{0\le s\le f}\int s\,d\mu现代概率中的期望
\mathbb E[X]=\int_\Omega X\,dP与极限定理、乘积测度及随机过程自然相连
但还有一个问题,我认为值得我们继续深入思考。
我们已经证明了控制收敛定理:
如果 X_n\to X 几乎处处,并且
|X_n|\le Y,\qquad \mathbb E[Y]<\infty,那么
\mathbb E[|X_n-X|]\to0.这说明在一定条件下,几乎必然收敛能够推出 L^1 收敛。
可我们也看到尖峰反例:
X_n\to0\quad\text{a.s.},却满足
\mathbb E[|X_n|]=1.因此,几乎必然收敛本身不意味着 L^1 收敛。
但另一方面,第二章还曾经讨论过:
X_n\xrightarrow{P}X.第三章又出现了:
X_n\xrightarrow{d}X.而第四章甚至研究了:
X_n\Longrightarrow X
\quad\text{in }C([0,1]).
我们似乎已经拥有了许多种“趋于同一个随机对象”的数学表达,却还没有建立它们之间的完整联系。
那么问题就来了。
如果我们说一列随机变量正在趋向另一个随机变量,到底应该要求什么?
是每一条样本路径上的值越来越接近?
还是偏差超过某个阈值的概率越来越小?
或者只要求对应的概率分布越来越相似?
这些要求是否等价?
如果不等价,为什么我们需要保留这么多不同的收敛概念?
这会是接下来极其重要的一次思想转变。
下一章:第七章《收敛究竟意味着什么?——随机世界中的四种极限》
我们将从一个看似违反直觉的问题开始:
假设一个事件在第
n次发生的概率趋近于零,为什么它仍然可能几乎必然发生无穷多次?
这个问题将把我们重新带回第二章的大数定律,并使我们发现:概率越来越小与一条样本路径最终不再出现异常,竟然是两种不同的数学性质。
随后我们将逐步建立:
\boxed{
\begin{aligned}
&\text{Almost sure convergence},\\
&\text{Convergence in probability},\\
&L^p\text{ convergence},\\
&\text{Convergence in distribution}.
\end{aligned}
}
我们不仅会陈述它们之间的关系,还将用严格反例理解每一个反向蕴含为何可能失败。
Borel–Cantelli 引理、子序列原理、uniform integrability、Portmanteau 定理和 Skorokhod 表示思想,将逐渐成为这一故事的自然组成部分。
最终,我们希望能够真正理解:
收敛并不是一个孤立的数学概念。选择哪一种收敛,实际上是在决定我们希望保留随机世界中的哪一种信息。
《偶然的数学》· 第二卷第六章 · 工作稿 v0.1