Haobai Wang · 公开阅读版 · ch07-zh-56bd85f8860c
内容指纹用于核对本章文本,不表示学术终审或独立的作者身份证明。
SHA-256: 56bd85f8860ce7b69c33031df04f03567e20311e968ec43de4da900908b5e664
《偶然的数学》
第二卷 · 无限世界中的概率
第七章:收敛究竟意味着什么?——随机世界中的四种极限
第六章的最后,我们留下了一根越来越窄、越来越高的尖峰。
在区间 [0,1] 上均匀选取一个点 U,令
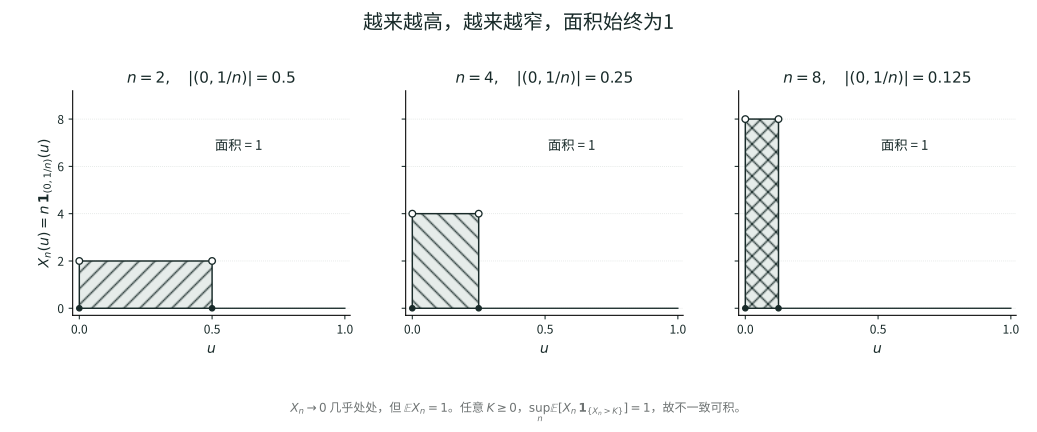
X_n=n\mathbf1_{\{0<U<1/n\}}.对于每一个固定的样本点,尖峰最终都会离开它。因此 X_n\to0 几乎必然成立。可无论把 n 取得多大,
\mathbb E[X_n]=1.我们已经看见一个极限,却没有得到另一个极限。
这究竟是积分不够听话,还是我们对“越来越接近”的理解本来就少了些什么?
现在再把问题转过来。假设第 n 次观察到异常的概率越来越小,我们是否就可以保证,一条实际的观察记录最终不再出现异常?
这一次,答案仍然可能是否定的。
尖峰提醒我们,逐条记录上的稳定未必控制平均损失;接下来的例子则会提醒我们,某一时刻看起来罕见的事情,仍可能在一生中反复发生。
为了理解这两种失败,我们需要重新追问第二章以来反复使用的那个词:收敛。
7.1 一扇越来越小,却不断走过每个人的窗口
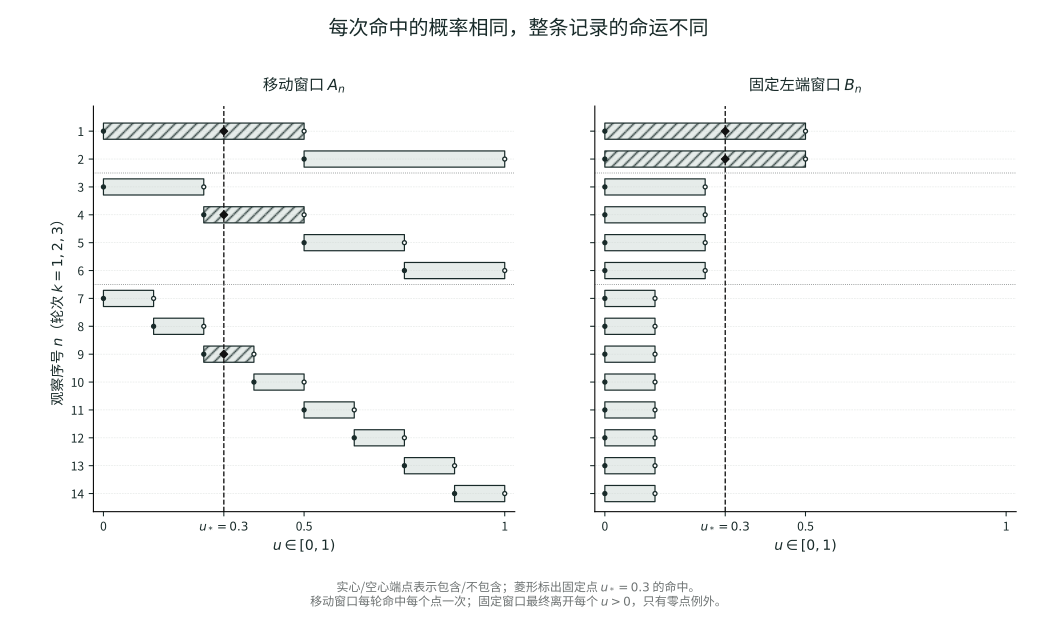
仍在 \Omega=[0,1) 上使用 Lebesgue 概率。我们把这个区间想象成所有可能的观察记录;选定一个 u,便是选定了一条记录。
第一轮,把区间平分成两份,依次打开两个窗口:
[0,1/2),\qquad[1/2,1).第二轮,把区间分成四份,再从左到右依次打开:
[0,1/4),\quad[1/4,1/2),\quad[1/2,3/4),\quad[3/4,1).第 k 轮有 2^k 扇窗口,每扇宽 2^{-k}。只有落在当前窗口里的记录,才在这一次观察中出现异常。
这不是一幅含糊的图景。记
N_0=0,\qquad N_k=\sum_{r=1}^k2^r=2^{k+1}-2,并对 k\ge1、0\le j<2^k 定义
A_{N_{k-1}+j+1}
=\left[\frac j{2^k},\frac{j+1}{2^k}\right),
\qquad Y_n=\mathbf1_{A_n}.
当观察次数 n 越来越大,所在的轮数 k 也越来越大,于是
P(Y_n=1)=P(A_n)=2^{-k}\longrightarrow0.可是,任意固定的 u\in[0,1),在每一轮都会恰好落入一扇窗口。所以每一条记录都会出现无穷多次异常。
而每一轮又至少有另一扇窗口不包含它。因此对每个 u,
\limsup_{n\to\infty}Y_n(u)=1,
\qquad
\liminf_{n\to\infty}Y_n(u)=0.
序列甚至没有逐点极限。
这个常被称作“打字机序列”的例子,像光标一样从左到右扫过区间。窗口缩小了,却没有停止寻找新的样本点。每一次看见异常的人越来越少,但没有任何一个人因此得到“以后再也轮不到我”的保证。
现在把同样大小的窗口全部固定在左端。若 n 属于第 k 轮,令
B_n=[0,2^{-k}),\qquad Z_n=\mathbf1_{B_n}.我们仍然有
P(Z_n=1)=P(Y_n=1).但对每个 u>0,从某一轮开始,所有窗口都落在它的左边。于是 Z_n(u)\to0;只有零点例外,而零点的概率为零。
两列随机变量在每一次观察中的分布完全相同,一列几乎必然趋零,另一列在每一条记录上不断振荡。
第一章曾经发生过类似的事。两局比赛各自公平,并不能决定两局共同的结局。现在,各时刻的异常概率,同样不能决定一条无限记录的命运。
我们缺少的,仍然是不同观察之间的联系。
7.2 从一个实数的数字,走向无穷多个事件
把一整个区间作为随机实验的空间,并不是为了专门制造反例。
Borel 在1909年发表的论文 Les probabilités dénombrables et leurs applications arithmétiques,把可数概率与算术问题联系起来。沿着这条线索,一个实数的无限数字展开,便成为理解无限随机记录的自然入口。原论文书目信息
下面采用现代的 Lebesgue 概率语言重建这个问题,不把现代记号或接下来的证明说成 Borel 当年的原文。
在 [0,1) 中均匀选择 U,写出它的二进制展开:
U=0.\xi_1\xi_2\xi_3\cdots\quad\text{(二进制)}.对有两种展开的二进有理数,统一选择最终为零的那一种。这些点是可数的,因而不影响以下概率结论。
若指定前 m 位数字,例如 0101\cdots,所得到的数恰好落在一个长度为 2^{-m} 的半开区间。因此每个指定的长度 m 的数字串都有概率 2^{-m}。
指定任意有限组数字的位置,只需先取到其中最大的那个位置,再数出尚未指定的位数。这给出
P(\xi_{i_1}=a_1,\ldots,\xi_{i_r}=a_r)=2^{-r},
\qquad a_j\in\{0,1\}.
所以这些数字是独立的公平 Bernoulli 随机变量。
值得停下来想一想:我们没有先假设一个尚未构造的无限硬币空间。第五章的长度测度,已经在一个随机实数内部,为我们容纳了一整列独立抛掷。
现在可以问,数字1在一条无限展开中,最终是否占一半?也可以问,某种越来越罕见的数字排列,是否仍会不断出现?
前一个问题通向强大数定律,后一个问题要求我们先说明“不断出现”究竟是哪一个事件。
对一列可测事件 A_1,A_2,\ldots,从第 N 次之后至少发生一次,对应
E_N=\bigcup_{n\ge N}A_n.无论把起点 N 推到多远,后面总还会发生一次,对应
\limsup_{n\to\infty}A_n
=\bigcap_{N=1}^{\infty}\bigcup_{n\ge N}A_n.
这就是 A_n 发生无穷多次的事件,通常简记为 \{A_n\ \mathrm{i.o.}\}。这里 i.o. 是 infinitely often。
它不是“某个特别遥远的时刻发生”。它同时检查所有足够遥远的起点。
而我们之所以能够给这个无限时间的命题赋予概率,正因为第五章允许我们做可数并与可数交。所谓抽象基础,在这里变成了描述一条无限记录所必需的语法。
7.3 怎样让所有遥远的异常一起消失?
如果只知道 P(A_n)\to0,第一节的移动窗口已经说明事情不够简单。
但如果连所有遥远异常的概率总和都很小呢?
概率的可数次可加性立刻给出
P(E_N)\le\sum_{n\ge N}P(A_n).因此,只要
\sum_{n=1}^{\infty}P(A_n)<\infty,右边的尾和便趋于零。又因为 E_N 随 N 递减,且 P(E_1)\le1,测度的上连续性说明
P(A_n\ \mathrm{i.o.})
=\lim_{N\to\infty}P(E_N)=0.
这就是 Borel–Cantelli 引理的第一个方向:若异常概率可求和,那么几乎每一条记录都只会出现有限次异常。
证明很短,但它改变了问题的层级。一个时刻的概率被换成所有未来时刻的概率上界;“越来越少”因此变成了“最终停止”。
这里完全没有使用独立性。异常之间可以有任意依赖关系,只要总概率预算有限,便不能在正概率的一批记录上无穷次地持续发生。
这也可以由第六章的积分语言重新看见。令
N(\omega)=\sum_{n=1}^{\infty}\mathbf1_{A_n}(\omega)表示异常的总次数,允许取无穷大。由单调收敛定理,
\mathbb E[N]=\sum_nP(A_n)<\infty.非负随机变量若有有限期望,就不可能以正概率等于无穷大:对任意 M>0,P(N\ge M)\le\mathbb E[N]/M,再令 M\to\infty 即可。
于是我们第二次得到 N<\infty 几乎必然成立。
同一件事有两种面貌:从事件看,是尾部并集的概率消失;从积分看,是有限平均次数排除了无限次数。这正是测度与积分在无限随机记录中的一次相遇。
但不要把这句话反过来。\mathbb E[N]=\infty 并不保证 N=\infty。第六章已经告诉我们,几乎必然有限的随机变量也可能有无穷期望。
所以当概率之和发散时,我们还需要新的条件。
7.4 独立性怎样使罕见事件不断回来?
假设 A_n 相互独立,并且 \sum_nP(A_n)=\infty。
从第 N 次到第 M 次一次都不发生的概率是
P\left(\bigcap_{n=N}^MA_n^c\right)
=\prod_{n=N}^M(1-P(A_n))
\le\exp\left(-\sum_{n=N}^MP(A_n)\right).
最后一步只用了 1-x\le e^{-x}。固定 N,令 M\to\infty,右边趋于零;左边由上连续性趋向 P(\bigcap_{n\ge N}A_n^c)。
因此,从任意给定的起点开始,以后永远不再发生的概率都是零。最后再对可数个起点取并,得到
\boxed{
\sum_nP(A_n)=\infty,\quad A_n\text{ 相互独立}
\quad\Longrightarrow\quad
P(A_n\ \mathrm{i.o.})=1.
}
这就是第二个方向。独立性让“每一次都有机会错过”变成“永远错过的机会被无穷多个乘积耗尽”。
独立并不是所有可能的充分条件中最弱的一个;但它已经清楚揭示了这个方向的机制。我们不能只把前一个引理的求和符号换成发散,再把结论反过来。
例如,在 (0,1) 上令 A_n=(0,1/n)。概率之和是调和级数,发散;可每个固定的 u>0 最终都离开所有 A_n,所以无穷次发生的概率仍为零。
这些事件不断缩进同一块区域,没有为大多数记录提供新的机会。
若希望一个概率趋零而仍无穷次发生的独立例子,也不必预先调用无限乘积测度定理。沿用第二节的独立二进制数字,把它们依次切成互不重叠的有限块。第 k 轮使用 2^k 个长度为 k 的块;每一块都使用从未使用过的数字位置。把“一块数字全为1”作为一次事件。
不同块的事件相互独立,每个第 k 轮事件的概率为 2^{-k},而该轮所有概率之和为
2^k\cdot2^{-k}=1.把各轮按顺序编号,单次概率趋于零,总和却发散。第二个引理于是说明:几乎每个随机实数的数字记录里,这种事件都会无穷次发生。
原来,越来越罕见并不等于越来越不可能重逢。一次机会的大小,和一生中机会累积的方式,是不同的信息。
Cantelli 在1917年的论文 Sulla probabilità come limite della frequenza 中研究概率与频率的极限关系;1935年的 Considérations sur la convergence dans le Calcul des probabilités 又直接讨论概率论中的收敛。这些原始文献也提醒我们,今天整理得整齐的收敛语言,来自对不同极限要求的长期辨析,而不是给同一个概念随意取了几个名字。1917年学院目录;1935年原文
在1935年讲稿的历史讨论中,Cantelli 特别回到一个容易被频率语言掩盖的差别:某个很晚时刻的频率以高概率接近真实概率,与从某个时刻起所有频率同时接近,并不是同一句承诺。这正是我们从第二章走到这里所面对的困难;无限多个时刻,不能由一次大样本的保证直接包办。原文第三部分
本章使用的是现代的 Borel–Cantelli 表述与证明,不据此断言历史论文的术语、假设和我们逐字相同。
7.5 第二章的硬币,终于得到逐条记录的答案
现在可以回到经验频率。
第二章对独立的公平硬币证明了,偏离 1/2 一个固定距离的概率趋于零。若只使用方差,得到的估计是
P\left(\left|\frac{S_n}{n}-\frac12\right|>\varepsilon\right)
\le\frac1{4n\varepsilon^2}.
右边虽然趋零,却不可求和。我们不能拿着这个上界,直接宣布异常只会发生有限次。
这不说明强结论是假的,只说明这个估计还不够锋利。
令 \eta_i=\xi_i-1/2,则 \eta_i 独立,取值为 \pm1/2,均值为零。展开四次方时,含有某个变量奇数次幂的项期望为零;留下来的只有一个位置出现四次,以及两个不同位置各出现两次:
\begin{aligned}
\mathbb E\left(\sum_{i=1}^n\eta_i\right)^4
&=\sum_i\mathbb E\eta_i^4
+6\sum_{i<j}\mathbb E\eta_i^2\mathbb E\eta_j^2\\
&=\frac n{16}+\frac{6}{16}\binom n2
=\frac{3n^2-2n}{16}.
\end{aligned}
因此,由非负变量的 Markov 不等式,
P\left(\left|\frac{S_n}{n}-\frac12\right|>\varepsilon\right)
\le\frac{3}{16\varepsilon^4n^2}.
这一次,概率上界可以求和。对每个固定的 \varepsilon>0,Borel–Cantelli 的第一个方向说明,超过这个误差的情况几乎必然只发生有限次。
但是,要得到收敛,还不能只固定一个误差阈值。我们对 \varepsilon=1,1/2,1/3,\ldots 分别应用结论,再取这些概率为1的事件的可数交。在同一个概率为1的集合上,对每个 m,最终都有
\left|\frac{S_n}{n}-\frac12\right|\le\frac1m.这才真正说明
\boxed{\frac{S_n}{n}\longrightarrow\frac12\quad\text{几乎必然}.}这里没有要求不同样本量对应的偏差事件独立;事实上它们通常高度依赖。我们只在计算四次矩时使用了原始硬币增量的独立性。
这一区别很重要。独立性究竟用在哪里,应当跟随证明看清楚,不能作为一句模糊的口令。
同样的计算对独立同分布、有界、均值为 p 的 Bernoulli 变量也成立。若 \eta_i=\xi_i-p,则 |\eta_i|\le1,展开式给出 \mathbb E(\sum_i\eta_i)^4\le3n^2,已经足以得到同样的可求和上界。因此任意固定 p\in[0,1] 的 Bernoulli 频率都几乎必然趋向 p。
这是一种强大数定律的完整证明,但它利用了这里的有界增量。一般可积独立同分布变量的强大数定律还需要截断等进一步工具,不能用这段四次矩计算替代。
7.5.1 从一位数字,到一个实数的全部有限图样
数字展开的问题还能再前进一步。
在任意整数底数 b\ge2 下,均匀实数的数字都可以用长度为 b^{-m} 的区间证明为独立、均匀取值于 \{0,\ldots,b-1\}。固定一个长度为 r 的数字串 w,它从某个位置开始出现的概率是 b^{-r}。
相邻位置的出现事件会重叠,不能直接当作独立硬币。我们把起始位置按模 r 分成 r 组:每一组内的数字块互不重叠,因而对应指示变量独立同分布。
刚才的有界 Bernoulli 强大数定律适用于每一组。每组出现频率趋于 b^{-r},而截至位置 n 的各组长度占比趋于 1/r,所以将各组重新合并,全部起始位置的出现频率也趋于 b^{-r}。
固定 b,r,w 时,这件事发生在一个概率为1的集合上。整数底数、串长及每种有限数字串的选择一共只有可数多个,再取一次可数交,我们得到:几乎每个实数,在每个整数底数下,每个有限数字串都以预期的频率出现。
这就是绝对正规性的概率结论的一条现代证明路线。这里证明的是几乎处处的性质,并没有因此判定某一个指定实数,例如 \sqrt2,具有这一性质。
从单次硬币的方差,到一条记录的稳定频率,再到几乎所有实数的数字结构,我们没有更换“概率”这个概念;我们改变了观察无限实验的方式。
7.6 两种“最终”:先固定一条记录,还是先固定一个时刻?
现在才是给两种要求正式命名的时候。
本章以下先在同一个概率空间 (\Omega,\mathcal F,P) 上研究实值可测随机变量 X_n,X。当谈到依分布收敛时,我们会明确说明,为什么不再需要它们共同生活在这个空间里。
所谓几乎必然收敛,是存在一个可测零集 N,使得对所有 \omega\notin N,都有通常实数意义下的 X_n(\omega)\to X(\omega)。记作
X_n\xrightarrow{\mathrm{a.s.}}X.它先固定一条记录,再沿着这条记录走向无限远处。不同记录所需要等待的时间可以完全不同;几乎必然收敛并没有给出一个适合所有人的共同截止日期。
所谓依概率收敛,则要求对每个 \varepsilon>0,
P(|X_n-X|>\varepsilon)\longrightarrow0,
\qquad\text{记作 }X_n\xrightarrow P X.
它在每个固定的晚时刻,计算仍然不够接近的那批记录占多大概率。它允许这批记录的成员一直变换。
第一节的移动窗口满足 Y_n\xrightarrow P0,却没有几乎必然极限;固定在左端的窗口 Z_n 则几乎必然趋零。两列变量逐时刻同分布,所以差异只能来自时间之间的共同结构。
7.6.1 为什么逐条记录稳定,会使异常的比例趋零?
设 X_n\to X 几乎必然。固定 \varepsilon>0,令
E_N(\varepsilon)=\bigcup_{n\ge N}\{|X_n-X|>\varepsilon\}.几乎每条记录最终不再超过这个误差,所以 \bigcap_NE_N(\varepsilon) 是零概率事件。由于 E_N 递减且概率有限,P(E_N)\to0。又有
P(|X_N-X|>\varepsilon)\le P(E_N(\varepsilon))\to0.我们得到了
X_n\xrightarrow{\mathrm{a.s.}}X\quad\Longrightarrow\quad X_n\xrightarrow P X.从第六章看,也可以对有界指示函数 \mathbf1_{\{|X_n-X|>\varepsilon\}} 应用控制收敛定理。两条证明依赖的是同一个事实:整个概率空间只有有限的总质量。
若把概率换成一般无限测度,这个蕴含不能照搬。实轴上的 \mathbf1_{(n,n+1)} 逐点趋零,但超过 1/2 的集合始终有测度1。质量能够不断向无穷远移动;概率空间的有限总质量,排除了这种形式的逃逸。
7.6.2 量词的次序,也是一种数学结构
固定 \varepsilon>0,依概率收敛说的是
\lim_{n\to\infty}P(|X_n-X|>\varepsilon)=0.几乎必然收敛则要求,对每个这样的阈值,所有遥远时刻的异常并起来,概率仍然消失:
\lim_{N\to\infty}P\left(\bigcup_{n\ge N}\{|X_n-X|>\varepsilon\}\right)=0.对可数阈值 \varepsilon=1/m 检查第二个式子,就与几乎必然收敛等价。它比第一个式子多做了一次对未来时间的统筹。
我们也可以把这种统筹变成一个更强的几何图景。给定 \delta>0,对每个 m 选择 N_m,使
P(E_{N_m}(1/m))<\delta2^{-m}.删去集合 H=\bigcup_mE_{N_m}(1/m),则 P(H)<\delta。在 H^c 上,对每个 m 和所有 n\ge N_m,都有 |X_n-X|\le1/m。因此收敛在 H^c 上是一致的。
这就是有限测度空间中 Egorov 现象的证明:几乎处处的收敛,可以在舍去任意小的一块概率后变成一致收敛。但我们没有得到一个固定的零集,使它在剩下的全部空间上一致;“任意小”不能被擅自换成“等于零”。
几乎必然与依概率收敛之所以不同,不是因为其中一个更接近日常语言。它们在时间和样本之间,安排了不同的量词次序。
7.7 不能让整列记录安静下来,能否选择一条更疏的时间线?
移动窗口迫使我们承认:依概率收敛不能直接升级为几乎必然收敛。
但它并没有让所有逐条记录的希望都破灭。依概率收敛允许我们等待足够久,使某个给定误差的发生概率小到任意程度。为什么不把这些等待组织起来?
设 X_n\xrightarrow P X。先选择 n_1,使 P(|X_{n_1}-X|>1/2)<1/2;再选择更大的 n_2,使误差超过 1/4 的概率小于 1/4。递归下去,可以取严格递增的 n_j,满足
P(|X_{n_j}-X|>2^{-j})\le2^{-j}.现在异常概率可以求和。Borel–Cantelli 告诉我们,几乎每条记录都只有有限多个 j 违反 |X_{n_j}-X|\le2^{-j}。因此
\boxed{X_{n_j}\xrightarrow{\mathrm{a.s.}}X.}这条选出的时间线不依赖样本点。我们先根据整批记录的概率选择 n_j,随后得到同一条时间线对几乎所有记录都有效。
这和“对每条记录分别挑一个好子序列”完全不同。后一种选择可能随记录变化,不能给出这里的统一概率结论。
更进一步,原序列的任意子序列仍然依概率收敛,所以都能再次抽取一个几乎必然收敛的子子序列。于是我们得到一个精确的判别:
实值随机变量 X_n 依概率收敛到 X,当且仅当每个子序列都存在一个几乎必然收敛到 X 的子子序列。
我们已经证明了正方向。反方向也值得完整看一遍。
若依概率收敛失败,就存在 \varepsilon,\delta>0,以及一个子序列 n_k,使所有 k 都有
P(|X_{n_k}-X|>\varepsilon)\ge\delta.按照假设,这个子序列还能抽出几乎必然趋于 X 的子子序列。但几乎必然收敛已经证明会推出依概率收敛,于是同一批偏差概率又必须趋零,与下界 \delta 矛盾。
注意判别中的“每个”。仅仅存在一个好的子序列,远远不够。例如确定性序列 0,1,0,1,\ldots 有恒为零的子序列,却不依概率收敛到零。
这是一种我们以后会不断使用的思想:不必强迫整列对象具有逐点性质,而可以要求每一次抽取之后,都仍然保留再找到逐点性质的机会。
7.7.1 一个极限为什么不能同时是两个不同的随机变量?
若 X_n\xrightarrow P X 且 X_n\xrightarrow P Y,对任何 \varepsilon>0,三角不等式给出
P(|X-Y|>\varepsilon)
\le P(|X-X_n|>\varepsilon/2)
+P(|X_n-Y|>\varepsilon/2).
令 n\to\infty,得到左边为零;再对阈值 1/m 取可数并,便有 X=Y 几乎必然。
所以这里的极限是唯一的,但唯一到一个零集为止。这与第六章的积分语言一致:概率和积分都无法分辨只在可测零集上不同的随机变量。这样的分辨率,不是理论的漏洞,而是它从一开始所选择的信息尺度。
7.8 如果误差很罕见,为什么平均损失还可能很大?
回到第六章的尖峰 X_n=n\mathbf1_{\{0<U<1/n\}}。它几乎必然趋零,当然也依概率趋零;可每一次罕见命中都会带来越来越大的数值,平均损失始终为1。
只计算“是否超过阈值”,会丢掉超过之后有多严重。
这句话可以被精确化。对 D_n=|X_n-X|,先把损失截断在1。若 0<\varepsilon<1,则
\varepsilon P(D_n>\varepsilon)
\le\mathbb E[\min(1,D_n)]
\le\varepsilon+P(D_n>\varepsilon).
左边在异常集合上积分;右边把空间分成 D_n\le\varepsilon 和其补集即可得到。
因此,依概率收敛等价于
\mathbb E[\min(1,|X_n-X|)]\longrightarrow0.原来,依概率收敛也能用平均损失描述。只是这个损失有一道天花板:误差为10与误差为一百万,到了天花板之后不再有区别。
现在如果我们不截断,而是真正关心误差的平均大小,就会自然要求
\mathbb E|X_n-X|\longrightarrow0.这称为 L^1 收敛。
若大误差应受到更重的惩罚,就可以考虑 p 次方。对于 1\le p<\infty,设随机变量具有有限 p 阶绝对矩,我们记
\|Z\|_p=(\mathbb E|Z|^p)^{1/p},
\qquad
X_n\xrightarrow{L^p}X
\quad\Longleftrightarrow\quad
\mathbb E|X_n-X|^p\longrightarrow0.
这里的 L^p 空间由有限 p 阶矩的随机变量组成,并把几乎处处相同的变量视为同一个元素。\|\cdot\|_p 是其通常的范数;空间的完备性等进一步结构并不是下面推导的前提,我们先关注这个量为什么适合衡量随机误差。
对 p=2,我们要求均方误差消失。这与第二章的方差估计直接相连:如果估计量无偏,均方误差就是它的方差。对 p=1,我们要求绝对误差的平均消失,而不允许正负误差互相抵消。
7.8.1 平均误差为什么能够控制异常概率?
在 \{|X_n-X|>\varepsilon\} 上,|X_n-X|^p>\varepsilon^p,所以
P(|X_n-X|>\varepsilon)
\le\frac{\mathbb E|X_n-X|^p}{\varepsilon^p}.
于是 L^p 收敛必然推出依概率收敛。
但它仍然不保证整列逐条记录收敛。第一节的移动窗口给出了一个特别鲜明的反例:对任意固定的有限 p\ge1,
\mathbb E|Y_n|^p=P(A_n)\to0,所以 Y_n\to0 在每一种这样的 L^p 意义下都成立,然而没有任何一条记录趋零。
惩罚误差的高度,与安排误差发生的时间,仍然不是同一个问题。
反过来,尖峰在每条记录上消失,却不在 L^1 中消失。L^p 与几乎必然收敛因而不能简单排成一条从弱到强的直线。
7.8.2 不同的平均损失之间,又是什么关系?
在概率空间上,若 1\le q\le p<\infty,则
\|Z\|_q\le\|Z\|_p.不必预先调用完整的 Hölder 理论,也能证明这里需要的估计。令 a=\mathbb E|Z|^p。若 a=0,结论显然;若 0<a<\infty,取 r=q/p\le1,利用非负数的切线不等式 t^r\le rt+1-r,得到
\mathbb E\left(\frac{|Z|^p}{a}\right)^r
\le r\mathbb E\frac{|Z|^p}{a}+1-r=1.
移项便得到所需结论。因此 L^p 收敛推出 L^q 收敛。
逆向一般失败。若 q<p,取
H_n=n^{1/p}\mathbf1_{\{0<U<1/n\}},则
\mathbb E|H_n|^q=n^{q/p-1}\to0,
\qquad \mathbb E|H_n|^p=1.
大误差在较低次方下变得便宜,却仍在较高次方下留下不可忽略的贡献。
若采用本质上确界来定义 L^\infty 误差,要求则更强。即便 \mathbf1_{\{0<U<1/n\}} 几乎必然且在所有有限 L^p 中趋零,它的本质上确界始终为1。对于 0<p<1,也可研究 \mathbb E|X_n-X|^p\to0,但相应的 (\mathbb E|Z|^p)^{1/p} 不再是范数;本章的主线采用 p\ge1。
7.8.3 控制收敛定理重新解释了什么?
若 X_n\to X 几乎必然,并且 |X_n|\le G、\mathbb E G^p<\infty,那么同一个概率为1的集合上也有 |X|\le G。于是
|X_n-X|^p\le2^{p-1}(|X_n|^p+|X|^p)\le2^pG^p.第六章的控制收敛定理立即给出 L^p 收敛。
这个定理并没有把两种收敛概念宣布为等价。它增加了一个跨越所有时间的共同约束:没有任何一根越来越高的尖峰,能够绕过同一个可积的控制函数。
如果我们不愿要求存在这样一个共同上界,还能不能找到恰好足够的条件?这个问题很快就会把我们带到一致可积性。
不过,在追查平均损失之前,还有一种更早出现的极限值得辨认。第三章的钟形曲线,究竟是在说哪一种接近?
7.9 钟形曲线接近的,究竟是哪一个随机变量?
第三章写下
\frac{S_n-n\mu}{\sigma\sqrt n}\xrightarrow d N(0,1).这里右边首先指定的是一个分布,而不是原来那批硬币中某一条已经存在的记录。
我们可以在同一个空间上为所有样本量定义 S_n;但中心极限定理并没有因此指定某个 Z,并保证每条记录上的标准化误差都越来越接近这个 Z。
让我们用一个不需要渐近计算的例子把差异推到眼前。
在只有两个等可能结果的空间上,取 P(X=0)=P(X=1)=1/2,再令
X_{2n}=X,\qquad X_{2n-1}=1-X.每一个 X_n 都与 X 同分布。从直方图看,它们从第一天起就已经完全一样。
但在每条记录上,数值始终在0与1之间交替。特别是
P(|X_{2n-1}-X|>1/2)=1.所以不存在对这个 X 的依概率收敛。
如果我们只保留各自的概率分布,这些交替全部变得不可见。所谓依分布收敛,正是要在这个层面讨论极限。
对实值随机变量,令
F_n(x)=P(X_n\le x),\qquad F(x)=P(X\le x).我们定义 X_n\xrightarrow d X,如果对 F 的每个连续点 x,都有 F_n(x)\to F(x)。这个记号也常写为 X_n\Rightarrow X。
这里完全可以使用不同空间 (\Omega_n,\mathcal F_n,P_n) 上的 X_n,把 F_n 改写为 P_n(X_n\le x);极限变量也可以生活在另一个空间。我们只比较实数轴上的分布。
为什么不要求在每个点收敛?考虑确定性变量 X_n=1/n、X=0。每个点的数值都在接近0,但
F_n(0)=0,\qquad F(0)=1.问题不在数值的接近,而在区间 ( -\infty,0] 的边界上突然出现了一个原子。我们不应该让这种边界选择摧毁一个本来应当成立的极限。
因此,连续点的限制,是为了区分分布本身的接近与某个尖锐边界上质量的归属。
7.9.1 为什么依概率收敛会使分布接近?
若 X_n\xrightarrow P X,在事件 \{|X_n-X|\le\varepsilon\} 上有
X\le x-\varepsilon\Longrightarrow X_n\le x,
\qquad
X_n\le x\Longrightarrow X\le x+\varepsilon.
从而
F(x-\varepsilon)-P(|X_n-X|>\varepsilon)
\le F_n(x)
\le F(x+\varepsilon)+P(|X_n-X|>\varepsilon).
先令 n\to\infty,再让 \varepsilon\downarrow0。若 x 是 F 的连续点,两端都趋向 F(x),于是 F_n(x)\to F(x)。
这证明了依概率收敛推出依分布收敛。但交替的 Bernoulli 例子已经证明,反方向不能成立。
当极限是常数 c 时,却有一个重要的例外。若 X_n\xrightarrow d c,对任何 \varepsilon>0,c-\varepsilon 与 c+\varepsilon 都是极限分布函数的连续点,所以
P(|X_n-c|>\varepsilon)
\le F_n(c-\varepsilon)+1-F_n(c+\varepsilon)\to0.因此,向常数的依分布收敛,等价于向该常数的依概率收敛。
这正好解释了一种常见经验:弱大数定律的极限是常数,分布层面的集中已经足够;中心极限定理的极限仍然随机,分布收敛就不能擅自升级为原空间中的数值接近。
7.10 不再追逐区间端点:让每一种连续观察都趋于稳定
分布函数为实数轴提供了方便的坐标,但它不像一个适合随机函数或随机树的定义。对于一条路径,什么才应该扮演“X\le x”的角色?
我们先在实数轴上换一种眼光。
假设观察仪器输出的不是某个尖锐事件的真假,而是一个有界连续函数 f(X)。我们比较仪器在两种分布下的平均读数。一个自然的要求是
\mathbb E[f(X_n)]\longrightarrow\mathbb E[f(X)]
\quad\text{对每个有界连续 }f:\mathbb R\to\mathbb R.
它和刚才的分布函数定义,恰好等价。我们把这件事证明出来,才能知道这个新眼光没有丢掉原来的极限。
7.10.1 怎样用连续的仪器逼近一个区间?
先假设所有有界连续读数的期望都收敛。给定 x 与 \delta>0,构造两个连续斜坡:一个在 x-\delta 以前为1,到 x 降到0;另一个在 x 以前为1,到 x+\delta 降到0。两者在其余方向保持0或1。
记它们为 \ell_\delta,u_\delta,就有
\ell_\delta(t)\le\mathbf1_{\{t\le x\}}\le u_\delta(t).分别取 X_n 下的期望并过极限,可得
F(x-\delta)\le\liminf_nF_n(x)
\le\limsup_nF_n(x)\le F(x+\delta).
若 F 在 x 连续,令 \delta\downarrow0,就得到所需的分布函数收敛。
斜坡让边界被缓慢地接近,而不是一次跳过去。极限分布不给边界质量时,这种缓慢接近不会留下误差。
7.10.2 区间概率又怎样控制任意连续读数?
反过来,我们手中只有各个区间的概率,想恢复的却是整条实数轴上任意连续仪器的读数。困难有两层:读数随位置变化,实数轴又没有尽头。我们先把几乎所有概率留在一个有限区间里,再用有限个刻度近似那里的读数;这时,分布函数提供的信息才足够逐一接管这些刻度。
设 F_n 在 F 的所有连续点趋于 F,并取有界连续 f,令 |f|\le M。若 M=0,结论显然。
首先选择两个足够远的连续点 a<b,使
F(a)+1-F(b)<\eta.这是可能的:分布函数的两端极限分别是0与1,而不连续点至多可数。后一个事实也有简单原因:大小至少为 1/m 的跳跃至多有 m 个,所有正跳跃点是这些有限集的可数并。
由端点概率收敛,当 n 足够大时,P(X_n\notin(a,b])<2\eta;极限变量相应的尾部概率小于 \eta。于是两边尾部读数的误差总共至多 3M\eta。
远处的读数已经用有界性控制住了,剩下的是近处读数怎样变化。在紧区间 [a,b] 上,f 一致连续;这意味着同一套足够细的刻度可以控制所有位置。把区间分成有限个足够短的区间 (t_{j-1},t_j],使全部端点均为 F 的连续点,并使 f 在每段内的振荡小于 \eta。每段取一个代表值 c_j。
于是内部积分可以用有限和近似:
\sum_j f(c_j)\,[F_n(t_j)-F_n(t_{j-1})].每个系数都收敛到对应的极限区间概率,而两边的近似误差各不超过 \eta。所以
\limsup_n|\mathbb Ef(X_n)-\mathbb Ef(X)|
\le 2\eta+3M\eta.
令 \eta\downarrow0,证明完成。
回头看,证明中的两次近似各自承担了不同的责任:先控制远处的概率,再控制近处的振荡。实数轴上的有限分割把这两件事接在一起,也为以后走向一般空间留下了线索。
“有界”与“连续”各自做了一件事。有界性防止罕见的大数值支配读数;连续性防止无限微小的移动跨过一个有质量的尖锐边界。
去掉前者,第六章的尖峰会让 f(x)=x 的期望失控。去掉后者,X_n=1/n\to0 对 f=\mathbf1_{\{0\}} 的读数始终为0,极限读数却为1。
这些限制不是为了迁就证明而随意添加的。它们准确对应两种不同的失败方式。
至此,四种极限已经逐渐分开:逐条记录、异常概率、平均损失、分布的连续读数。可尖峰留下的那个问题仍然没有解决。有没有比同一个可积上界更灵活的办法,让平均损失重新服从极限?
7.11 尖峰真正带走的,不是概率,而是平均损失
再看一次 X_n=n\mathbf1_{\{0<U<1/n\}}。它非零的概率只有 1/n,但只要取 n>K,就有
\mathbb E\bigl[|X_n|\mathbf1_{\{|X_n|>K\}}\bigr]=1.无论把“大数值”的门槛 K 放得多高,总有一根更高的尖峰,把全部平均损失放在门槛之外。
所以问题不只是 \sup_n\mathbb E|X_n|<\infty。我们还需要:这份有限的平均损失,不能在越来越高的数值区域里重新聚集。
对于一族可积随机变量 \mathcal X,我们称它一致可积,如果
\boxed{
\lim_{K\to\infty}\sup_{Y\in\mathcal X}
\mathbb E\bigl[|Y|\mathbf1_{\{|Y|>K\}}\bigr]=0.
}
英文 uniform integrability 常缩写为 UI。若 \mathcal X=\{X_n:n\ge1\},就说这列随机变量一致可积。
每一个单独的可积变量都满足自己的尾部期望趋零。这由控制收敛定理立即得到:|Y|\mathbf1_{\{|Y|>K\}}\to0,且被可积的 |Y| 控制。
新要求在于同一个 K 要同时适用于整族变量。先固定一个 n 再让门槛增大,与先把所有 n 放在一起再提高门槛,又出现了量词顺序的区别。
7.11.1 怎样从数值尾部,看见小概率集合?
若一族变量一致可积,先取一个 K\ge1,使所有尾部期望都小于1。那么
\sup_{Y\in\mathcal X}\mathbb E|Y|\le K+1<\infty.而对于任意事件 A,
\mathbb E[|Y|\mathbf1_A]
\le K P(A)
+\mathbb E[|Y|\mathbf1_{\{|Y|>K\}}].
给定 \varepsilon>0,先选 K 使第二项对全部 Y 都小于 \varepsilon/2,再让 P(A)<\varepsilon/(2K),便得到
\sup_{Y\in\mathcal X}\mathbb E[|Y|\mathbf1_A]<\varepsilon.这说明一件极其贴近原问题的事:在足够小概率的集合上,整族变量能够产生的平均损失也一致地小。
反过来,假设这项小集合性质成立,并且 C=\sup_{Y\in\mathcal X}\mathbb E|Y|<\infty。若 C=0,结论显然。否则,给定 \varepsilon>0,从小集合性质取一个 \delta>0。再选 K>C/\delta,Markov 不等式给出
P(|Y|>K)\le C/K<\delta对全部 Y 成立。将 A=\{|Y|>K\} 放入小集合性质,就得到一致可积性。
因此,UI 等价于两项要求同时成立:绝对一阶矩一致有界,并且积分对小概率集合具有一致的绝对连续性。
一阶矩有界不能在这个判别中随意省略。若概率空间只有一个点,变量 Y_n=n 对所有足够小概率的事件都满足小集合条件,因为这样的事件只能是空集;可它们显然不一致可积。
这个极端例子说明,定理中的条件不是装饰。一般概率空间上,我们必须同时控制整体的预算与小区域中的集中。
7.11.2 为什么高一阶的矩,会阻止坏的尾部?
若存在某个 p>1,使 \sup_n\mathbb E|X_n|^p=C<\infty,那么在 |X_n|>K 上,
|X_n|\le K^{1-p}|X_n|^p.故
\sup_n\mathbb E[|X_n|\mathbf1_{\{|X_n|>K\}}]
\le C K^{1-p}\to0.
所以一致的高阶矩界,是 UI 的一个十分方便的充分条件。它比 UI 本身更强,不能被当作定义。
例如,在 (0,e^{-1}) 上取密度为 e 的均匀概率,令
Y(u)=\frac1{u[\log(1/u)]^2}.换元 t=\log(1/u) 得
\mathbb E Y=e\int_1^\infty t^{-2}\,dt=e<\infty,但对任意 p>1,
\mathbb E Y^p=e\int_1^\infty e^{(p-1)t}t^{-2p}\,dt=\infty.最后一个积分发散,是因为指数增长最终压过任意多项式衰减。常值序列 X_n=Y 一致可积,却没有任何这样的高阶矩界。
共同的可积控制函数也是 UI 的充分条件:若 |X_n|\le G 且 G 可积,尾部贡献不超过 \mathbb E[G\mathbf1_{\{G>K\}}]。但 UI 不要求所有变量必须躲在同一座可积的天花板之下,它直接约束我们真正关心的尾部积分。
7.12 依概率接近,加上不丢失平均损失,会发生什么?
上一节已经把数值尾部的限制,转成了对小概率集合上积分的统一控制。现在让这些集合恰好取成 \{|X_n-X|>\varepsilon\}:依概率收敛会让它们缩小,UI 则不许尖峰把损失藏进其中。这样,两种原本不同的收敛要求终于有了合作的可能。
精确的结果是:**若实值可测 X_n 依概率收敛到实值可测 X,且每个 X_n 可积,那么 X_n\to X 在 L^1 中成立,当且仅当 \{X_n\} 一致可积。**在 UI 的方向,X 的可积性无需另外假设,会由条件推出。
这是概率空间上的 Vitali 收敛判别。我们不只把它当作对控制收敛定理的命名推广;我们要看清楚每一部分为何缺一不可。
7.12.1 先保证极限真的可以求平均
UI 已经给出 \sup_n\mathbb E|X_n|=C<\infty。由子序列原理,可以取 X_{n_j}\to X 几乎必然。对非负的 |X_{n_j}| 使用 Fatou 引理,得到
\mathbb E|X|\le\liminf_j\mathbb E|X_{n_j}|\le C.于是极限可积。
这里只从原序列取了一个几乎必然子序列,并没有偷偷假设整列都几乎必然收敛。证明需要逐条记录时,子序列原理为我们提供了恰好足够的桥。
7.12.2 把总误差分成“很小”与“很罕见”
给定 \varepsilon>0,由 UI 的小集合判别,存在 \delta_1>0,使 P(A)<\delta_1 时,所有 n 都有
\mathbb E[|X_n|\mathbf1_A]<\varepsilon.同样,单个可积变量 X 的积分也对小概率集合绝对连续:先把 |X| 超过某个大门槛的尾部积分压到 \varepsilon/2,再用门槛乘上 P(A) 控制剩余部分。于是也可取 \delta_2>0,使相应积分小于 \varepsilon。
令
A_n=\{|X_n-X|>\varepsilon\}.依概率收敛保证,当 n 足够大时,P(A_n)<\min(\delta_1,\delta_2)。在 A_n^c 上,误差至多 \varepsilon;在 A_n 上,用 |X_n-X|\le|X_n|+|X|。因此
\begin{aligned}
\mathbb E|X_n-X|
&\le\varepsilon+
\mathbb E[|X_n|\mathbf1_{A_n}]
+\mathbb E[|X|\mathbf1_{A_n}]\\
&<3\varepsilon.
\end{aligned}
\varepsilon 可以任意小,故 L^1 收敛成立。
第六章尖峰破坏的,正是异常区域上的两项积分;这里的小集合估计终于把它们同时压了下去。
7.12.3 为什么 L^1 收敛也必然留下 UI?
反过来,设 X_n\to X 在 L^1 中成立。由
\mathbb E|X_n|\le\mathbb E|X_n-X|+\mathbb E|X|可知一阶矩一致有界。
给定 \varepsilon>0,先取 N,使所有 n\ge N 都有 \mathbb E|X_n-X|<\varepsilon/2。若事件 A 的概率足够小,就有 \mathbb E[|X|\mathbf1_A]<\varepsilon/2,于是所有 n\ge N 满足
\mathbb E[|X_n|\mathbf1_A]
\le\mathbb E|X_n-X|+\mathbb E[|X|\mathbf1_A]
<\varepsilon.
还剩前面有限多个可积变量 X_1,\ldots,X_{N-1}。对它们分别选择合适的小集合阈值,再取这些阈值的最小值,就能使同一个条件对全部 n 生效。
由小集合判别,\{X_n\} 一致可积。另一方面,L^1 收敛已经推出依概率收敛,所以整条等价关系的两个方向都完成了。
7.12.4 控制收敛不再要求逐条记录先行
假如我们只知道 X_n\xrightarrow P X,却仍有 |X_n|\le G、G 可积,UI 自动成立,刚才的判别便给出 L^1 收敛。
因此,对概率空间上的期望交换极限来说,控制收敛定理常见的“几乎必然收敛”前提可以放宽成“依概率收敛”。这不是忽略了逐点论证,而是子序列原理与 Fatou 引理已经替我们承担了相应工作。
若更一般地 |X_n|\le G、\mathbb EG^p<\infty,还可以得到 L^p 收敛。确切地说,任取子序列,都能抽出几乎必然趋于 X 的子子序列;沿它有 |X|\le G 几乎必然,且由第7.8节的控制估计,\mathbb E|X_{n_j}-X|^p\to0。若整列这些非负期望不趋零,就能先取一个始终有正下界的子序列,与刚才的抽取性质矛盾。
我们由此学会了一种强有力的证明方法:先把问题放到一个逐条记录可用的子序列里解决,再检查任何失败的子序列都无法逃脱这个结论。
7.13 期望相同,为什么还不能说明损失消失?
Vitali 判别控制了绝对误差,但在实际计算里,我们往往先得到的是带符号的期望。如果已经知道 \mathbb EX_n\to\mathbb EX,这份较容易取得的信息能不能代替 UI?
对有正有负的收益,答案是否定的。令
Z_n=n\mathbf1_{\{0<U<1/(2n)\}}
-n\mathbf1_{\{1/(2n)\le U<1/n\}}.
那么 Z_n\to0 几乎必然,并且
\mathbb E Z_n=0\longrightarrow0,
\qquad
\mathbb E|Z_n|=1.
正负两根尖峰在期望里恰好抵消了,却没有让误差消失。这正是为什么 L^1 使用绝对值,而不能只比较两个带符号的平均。
非负变量有一个更精确、也更美的例外。若 X_n\ge0、X\ge0,均可积,X_n\to X 几乎必然,且 \mathbb EX_n\to\mathbb EX,则
|X_n-X|=X_n+X-2\min(X_n,X).右边的最小值趋于 X,并被可积的 X 控制。由控制收敛,
\mathbb E|X_n-X|
=\mathbb EX_n+\mathbb EX-2\mathbb E\min(X_n,X)
\longrightarrow0.
这类结论常称作 Scheffé 型论证。非负性阻止了正负抵消,于是“总质量没有丢失”与逐点接近共同迫使绝对误差消失。若只给定依概率收敛,同样可用子序列原理将这段论证提升到整列。
7.13.1 分布已经接近,UI 能否恢复平均读数?
还可以再弱一点。假设我们仅有 X_n\xrightarrow d X,并且 \{X_n\} 的绝对值尾部期望一致趋零;这里变量不必在同一个概率空间中。
第7.10节只让有界连续的仪器通过了极限;现在要接回无界的读数 f(x)=x。此前两种截断操作在这里会合:分布收敛处理固定门槛内的读数,UI 让我们最后安全地撤掉门槛。
这里没有同一空间中的差值可供估计,因而不能直接调用 Vitali。先从分布本身确认极限可积:UI 给出 C=\sup_n\mathbb E|X_n|<\infty。函数 x\mapsto\min(|x|,R) 有界连续,所以
\mathbb E\min(|X|,R)
=\lim_n\mathbb E\min(|X_n|,R)\le C.
令 R\to\infty,单调收敛说明 X 可积。
取连续截断函数 T_K(x)=\max(-K,\min(x,K))。分布收敛给出 \mathbb ET_K(X_n)\to\mathbb ET_K(X),而
|\mathbb EX_n-\mathbb ET_K(X_n)|
\le\mathbb E[|X_n|\mathbf1_{\{|X_n|>K\}}].
右边由 UI 一致趋零,极限变量相应的尾部也因可积性趋零。因此先令 n\to\infty,再令 K\to\infty,便得到 \mathbb EX_n\to\mathbb EX。
但这仍然不是原来变量之间的 L^1 收敛。第7.9节交替的 Bernoulli 变量有相同分布、相同期望,而且一致有界,当然一致可积;它们对指定的 X 却连依概率收敛都没有。
UI 让我们恢复了对分布的无界平均读数,没有替我们发明一组原本不存在的联合关系。
7.14 四种极限,原来在保留四种不同的信息
经历这些例子之后,再把关系放在一起,就不再是一张需要死记的箭头图。
对于同一概率空间上的实值变量,以及 1\le q\le p<\infty,我们已经证明
\begin{gathered}
X_n\xrightarrow{\mathrm{a.s.}}X\ \Longrightarrow\ X_n\xrightarrow P X\ \Longrightarrow\ X_n\xrightarrow d X,\\
X_n\xrightarrow{L^p}X\ \Longrightarrow\ X_n\xrightarrow{L^q}X\ \Longrightarrow\ X_n\xrightarrow P X.
\end{gathered}
而从依概率走回 L^1,恰好需要 UI:
X_n\xrightarrow{L^1}X
\quad\Longleftrightarrow\quad
X_n\xrightarrow P X\ \text{且 }\{X_n\}\text{ 一致可积},
其中 X_n 可积,极限 X 为实值可测变量,右侧条件会推出它可积。
| 想反过来走的箭头 | 阻止它的随机现象 |
|---|---|
依概率 \Rightarrow 几乎必然 |
移动窗口每次只击中少数人,却反复击中每个人 |
任意有限 L^p \Rightarrow 几乎必然 |
同一个有界移动窗口,所有有限阶平均损失都消失,时间上的反复仍存在 |
几乎必然或依概率 \Rightarrow L^1 |
收缩尖峰把平均损失藏在越来越罕见的大数值里 |
L^q\Rightarrow L^p,q<p |
高度 n^{1/p}、宽度 1/n 的尖峰,在较高次方下仍留下质量 |
依分布 \Rightarrow 依概率 |
逐时刻同分布的交替变量,保留直方图却改变了原空间里的配对 |
这张表不是要求每一种极限都尽可能加强。它提醒我们,不同问题本来就要求不同的信息。
若要描述一条真实观察记录是否最终稳定,几乎必然收敛是自然语言;若要给一个大样本估计以高概率的精度保证,依概率收敛往往已经回答问题;若要控制平均损失或交换期望,必须检查积分层面;若要识别标准化波动的形状,分布收敛才允许不同微观模型走向同一个极限规律。
把所有这些要求揉成一个“收敛”,反而会掩盖概率论真正研究的差异。
7.15 如果分布相同,能不能重新安排一次相遇?
在交替的 Bernoulli 例子里,我们已经拥有一列分布完全相同的变量,为什么却看不到数值的接近?因为我们沿用了原来的配对。
但若允许在另一个空间上重新实现这些分布,就可以取一个 Bernoulli 变量 Z,让所有新变量 Y_n 都等于 Z。此时每个 Y_n 仍与原来的 X_n 同分布,而 Y_n\to Z 甚至处处成立。
我们没有改善旧变量的收敛。我们保留了每一个单独的分布,却更换了它们共同生活的方式。
这就是 **coupling(耦合)**的基本思想:为给定的边际分布选择一个联合实现。
在实数轴上,还有一种特别自然的安排。若 F 是分布函数,定义广义分位数
Q(u)=\inf\{x\in\mathbb R:F(x)\ge u\},\qquad 0<u<1.取同一个均匀变量 U,则 Q(U) 具有分布函数 F。因为分布函数的单调性和右连续性给出 Q(u)\le x 当且仅当 u\le F(x),两边取均匀概率就得到 P(Q(U)\le x)=F(x)。这里 0<u<1 保证广义分位数是有限的,端点不影响均匀概率。
因而,对一列分布函数 F_n,可以把 Q_n(U) 与 Q(U) 放在同一条均匀刻度上。这样做只保留了原来的单时刻分布,不会保留原变量之间的独立性或其他联合结构。
在实值分布弱收敛的条件下,这种分位数安排能够给出几乎必然收敛的实现;其关键在于广义分位数在几乎所有均匀刻度上的收敛。进一步的 Skorokhod 表示理论则在适当的可分完备度量空间中处理类似问题。证明这些结论时,需要认真控制分位数的连续点或空间的拓扑结构;我们在进入弱收敛理论时再沿着这条问题线索展开。
此时最需要记住的,是它们的结论所允许改变的东西:新空间中的逐点收敛,并不等于原来观察记录中的逐点收敛。
第一章的联合概率、第四章的有限维分布与本章的分布收敛,在这里又会合了一次。边际规律从来没有替我们唯一决定联合世界。
7.15.1 如果结果不再是实数,连续读数还剩下什么?
对于度量空间 S 中的随机元素,只要明确其 Borel 可测结构与分布,就可以用同一个方向提出弱收敛问题:是否对所有有界连续 f:S\to\mathbb R,都有积分收敛?
这种提问不再依赖实数的大小顺序,所以同样可以指向连续路径、随机树或随机测度。
但哪些事件的概率会随之收敛?1/n\to0 的例子已经说明,不能期待所有可测集合都成功。边界上的质量仍然会成为障碍。一般弱收敛理论中的 Portmanteau 定理,会把有界连续观察与开集、闭集的单边概率估计,以及边界零质量集合的概率收敛联系起来。
这里不是忽然多了一组需要背诵的等价命题。我们刚才已经亲眼见到它们为何必然出现:连续仪器需要逼近尖锐事件,而边界决定这种逼近能否无损完成。
还有概率质量会不会逃走的问题。对一个实值极限分布,选取很大的紧区间,可以让绝大多数概率留在其中;第7.10节正是利用了这件事,才能把有限区间上的近似提升为全空间结论。到一般度量空间时,我们必须把其中两个不同的要求说清楚。
对于 S 上的一个 Borel 概率测度 \mu,若
\forall\varepsilon>0\ \exists K\subseteq S\text{ 紧},
\qquad \mu(K)\ge1-\varepsilon,
就称 \mu 紧(tight)。这里的紧集可以随 \varepsilon 与这个测度而改变。
对于一族 Borel 概率测度 \mathcal P,若
\forall\varepsilon>0\ \exists K\subseteq S\text{ 紧},
\qquad \inf_{\mu\in\mathcal P}\mu(K)\ge1-\varepsilon,就称这族测度一致紧(uniformly tight)。有些文献也把后一种性质简称为“分布族紧”;关键不在简称,而在同一个紧集必须同时容纳整族测度的绝大多数概率。
每个实数轴上的概率测度都是紧的,因为 [-R,R]\uparrow\mathbb R。但这不保证一族测度一致紧:\delta_n 分别把全部质量放在整数 n 上,每一个都紧,任何固定紧集却只能包含有界的整数位置,无法同时约束全部 n。寻找一列分布的弱极限时,真正需要考察的是后一种统一约束,而不只是逐个检查它们都紧。
不要把紧性与一致可积混为一谈。对尖峰 X_n=n\mathbf1_{\{0<U<1/n\}},若 R\ge1,则
\sup_nP(|X_n|>R)
\le\frac1{\lfloor R\rfloor+1}\longrightarrow0.
所以其分布族在实数轴上是一致紧的。但对任意 K,只要 n>K,尾部期望仍等于1,UI 失败。
逃向大数值区域的概率已经很少,不等于那里的数值加权贡献也很少。
第四章的路径问题又会增加另一层困难:一个时刻的位移不逃走,并不保证整条函数没有越来越尖锐的振荡。那时,紧集不再只是一个大区间,我们必须理解哪些函数集合能够相互靠近、哪些路径波动会阻止紧性。
于是,Borel–Cantelli、积分、分布与函数空间开始出现在同一条道路上。它们各自控制不同的信息,却会在需要更完整的随机极限时共同工作。
第七章结语:我们想让随机世界保留下什么?
想象再次沿着一条无限的观察记录向前走。
一扇小窗口可能一次又一次扫过我们,尽管每次被它击中的概率都在下降;另一根尖峰可能终于离开每一条固定记录,却始终把一份不变的平均损失留在总体中。
这两个最初的困难没有互相否定。它们只是告诉我们,“到了后来”可以有不同含义。
Borel–Cantelli 让我们能够把所有遥远时刻一起考虑。它把可求和的概率预算变成有限次异常,也让独立的无穷多次机会耗尽永远逃避的可能。大数定律因此不再只是某个晚时刻的高概率保证,而能够成为几乎每条记录的长期命运。
然而,记录的命运还不能决定平均损失。Lebesgue 积分让我们看见的那些尖峰,需要由一致可积性来约束。它不要求每个变量都被同一座天花板罩住,却要求任何越来越小的概率区域,都不能藏住不肯消失的平均贡献。
而当我们重新凝视第三章的 Gaussian 曲线时,又发现有些极限根本不是在追踪同一条记录。它们保留的是分布的形状,是每一种有界连续观察的平均读数。若想把这样的分布重新安排成逐点接近的变量,就必须认真决定它们如何共同实现。
所以,四种收敛不是四个彼此争夺地位的定义。它们分别回答:一条记录会怎样,一批异常有多大,平均损失是否消失,以及总体分布呈现什么形状。
我们不需要每次都选择最强的要求。我们需要知道,眼前的问题究竟要保留哪一种随机信息,以及为了得到更多信息,还必须支付什么条件。
第四章的那颗微粒仍然在等待一条真正的连续随机路径。现在,我们终于能够说清楚:固定时刻的 Gaussian 极限,只回答了其中一种收敛;整条路径的诞生,还需要概率测度的构造、路径空间的可测性与适当的弱收敛理论。
下一步,我们会面对一个与本章开头恰好相反的问题。本章从已经给定的一整个概率空间出发,研究其中的无限序列。可是,如果最初只给出了每一段有限实验的规则,我们是否总能让它们同时存在于同一个无限实验中?
一个实数的数字展开,已经让我们看到这种构造在特殊情形下怎样成功。但任意一组有限维规律要共同成立,还需要哪些一致性?当我们试图从有限走向无限时,可数可加性又会在哪一步成为关键?
我们已经学会区分极限中的不同承诺。现在,应该追问这些承诺所涉及的随机对象,究竟怎样被放进同一个数学世界。
历史与进一步阅读
Émile Borel,Les probabilités dénombrables et leurs applications arithmétiques,Rendiconti del Circolo Matematico di Palermo 27(1909),247–271。原论文出版记录。出版页面另列的2009年是网络记录时间,不是论文最初发表年份。
Francesco Paolo Cantelli,Sulla probabilità come limite della frequenza(1917)。意大利林琴科学院原始目录。F. P. Cantelli,Considérations sur la convergence dans le Calcul des probabilités,Annales de l'Institut Henri Poincaré 5(1935),3–50。原文影印及全文。
本章的符号、证明顺序、移动窗口与尖峰之间的比较,以及从子序列走向一致可积性的组织,均采用现代数学语言。它们不应被当作以上历史文献的原话或原证明复刻。
更一般的理论可参照 Olav Kallenberg,Foundations of Modern Probability,第三版(2021)中与积分、序列极限及分布收敛有关的部分。出版社书目信息。本章的叙事次序从前六章的问题发展而来。